4 Inicializar y evaluar
Herramientas: initialization-and-evaluation-ga, accesible desde el portal.
Al terminar el recorrido básico de este capítulo podrás:
- generar a mano los individuos de una población inicial uniforme a partir de números aleatorios dados, también cuando son permutaciones;
- medir la diversidad de una población con distancias y contar cuántos de sus individuos son factibles;
- explicar por qué sembrar la población inicial con una solución heurística suele ser una mala idea;
- calcular la aptitud de un individuo: decodificarlo, calcular el objetivo y la violación de las restricciones, y penalizarla;
- transformar un coste en una aptitud que sirva para la ruleta y calcular las probabilidades que resultan;
- contar las evaluaciones que hace una ejecución y explicar cuándo ahorra trabajo una caché.
4.1 Una población al azar BásicoB
Un algoritmo genético necesita individuos sobre los que actuar desde la primera generación. ¿De dónde salen?
Un algoritmo genético no empieza con una solución, sino con una población inicial de N individuos. Lo habitual es generarlos al azar (Talbi, 2009, p. 194; Mitchell, 1996/1998, apartado 1.6). La población inicial no tiene que ser buena: tiene que ser diversa, para que la selección, el cruce y la mutación tengan material variado con el que trabajar. Si está poco diversificada, el algoritmo puede converger antes de tiempo, es decir, quedarse estancado en una zona del espacio de búsqueda que no tiene por qué contener el óptimo (Talbi, 2009, p. 193).
Uniforme quiere decir que todos los cromosomas tienen la misma probabilidad de salir. Para conseguirlo basta con sortear cada gen por separado, con una regla que depende de su tipo. En todas, u es un número aleatorio uniforme entre 0 y 1:
- Un bit vale 1 si u < 0{,}5 y 0 en caso contrario.
- Un entero de 1 a m vale 1 + \lfloor u\,m \rfloor, donde \lfloor\cdot\rfloor es la parte entera. Cada valor sale con probabilidad 1/m.
- Un real del intervalo [a, b] vale a + u\,(b - a) (Talbi, 2009, p. 194).
Como los genes se sortean de forma independiente, cada combinación de genes tiene la misma probabilidad. La herramienta muestra cada número aleatorio con dos o tres decimales, para que se pueda comprobar cada gen a mano.
Usaremos un problema de asignación como el del capítulo 3, con 5 tareas y 3 máquinas, pero con otros tiempos:
| Tarea | Máquina 1 | Máquina 2 | Máquina 3 |
|---|---|---|---|
| 1 | 5 | 5 | 8 |
| 2 | 9 | 2 | 7 |
| 3 | 2 | 9 | 1 |
| 4 | 7 | 2 | 1 |
| 5 | 3 | 3 | 5 |
El cromosoma es un vector de enteros: el gen i es la máquina que hace la tarea i. Se minimiza el makespan, la mayor de las cargas de las máquinas. El óptimo de este problema vale 5.
Datos. Los tiempos de la tabla. Para el primer individuo se han sorteado los números u = 0,087; 0,277; 0,454; 0,226 y 0,980, uno por tarea.
Predice. ¿Qué máquina recibe cada tarea? ¿Cuánto vale el makespan de ese individuo?
Ver el resultado
Con m = 3, cada gen es 1 + \lfloor 3u \rfloor:
| Tarea | u | 3u | Máquina |
|---|---|---|---|
| 1 | 0,087 | 0,261 | 1 |
| 2 | 0,277 | 0,831 | 1 |
| 3 | 0,454 | 1,362 | 2 |
| 4 | 0,226 | 0,678 | 1 |
| 5 | 0,980 | 2,940 | 3 |
Mostrar aquí la herramienta (el primer individuo)
Los otros cinco individuos de esa población se generan igual, con números nuevos: sus makespans son 9, 8, 14, 14 y 14. Ninguno llega al óptimo, 5, y no tienen por qué: mejorar la población es trabajo de los operadores que vienen después.
Usa los números del ejemplo 4.1. (a) Con los cinco primeros, redondeados a dos decimales (0,08; 0,27; 0,45; 0,22; 0,98), genera una cadena de 5 bits. (b) Con los dos primeros, 0,087 y 0,277, genera un punto real de la caja [-5, 5]^2. (c) Si hubiera 4 máquinas en lugar de 3, ¿a qué máquina iría la tarea 5?
Ver la solución
Los cuatro primeros son menores que 0,5 y el último no: 1 1 1 1 0.
x_1 = -5 + 0{,}087 \times 10 = -4{,}13 y x_2 = -5 + 0{,}277 \times 10 = -2{,}23. El punto es (-4{,}13;\ -2{,}23).
1 + \lfloor 0{,}980 \times 4 \rfloor = 1 + \lfloor 3{,}92 \rfloor = 4: a la máquina 4.
Explorar en initialization-and-evaluation-ga
- Avanza con Siguiente por las etapas y comprueba cada gen con su número u.
- Cambia el Problema y codificación a la mochila, a la función con vector de reales y a la función con cadena binaria. ¿Qué regla se usa en cada caso?
- Pulsa Sortear la población varias veces. ¿Sale alguna vez un individuo con el makespan óptimo?
4.2 Barajar una permutación BásicoB
En el problema del viajante, el cromosoma es un orden de visita. ¿Se puede sortear gen a gen, como un vector de enteros?
No: una ciudad que ya ha salido no puede volver a salir, así que los genes de una permutación no son independientes. Si se sortea cada gen de 1 a n sin más, la mayoría de los resultados repiten ciudades y no son permutaciones, como vimos en la sección 3.5. La misma idea de inicialización uniforme sirve para permutaciones (Talbi, 2009, p. 195), pero hace falta otro procedimiento.
El método estándar para barajar es el de Fisher y Yates (1938), en la versión de Durstenfeld (1964):
- Se parte de la permutación (1, 2, \dots, n).
- Para k = n, n - 1, \dots, 2, se sortea una posición j = 1 + \lfloor u\,k \rfloor, entre 1 y k, y se intercambian las posiciones j y k. Desde ese momento, la posición k queda fija.
Con n - 1 números aleatorios, cada una de las n! permutaciones sale con la misma probabilidad.
Datos. Un viajante con n = 5 ciudades. Se han sorteado los números u = 0,087; 0,277; 0,454 y 0,226, uno para cada valor de k, de 5 a 2.
Predice. ¿Qué posición j sale en cada paso? ¿Qué permutación queda al final?
Ver el resultado
| k | u | j = 1 + \lfloor u\,k \rfloor | Intercambio | Permutación |
|---|---|---|---|---|
| 1 2 3 4 5 | ||||
| 5 | 0,087 | 1 | posiciones 1 y 5 | 5 2 3 4 1 |
| 4 | 0,277 | 2 | posiciones 2 y 4 | 5 4 3 2 1 |
| 3 | 0,454 | 2 | posiciones 2 y 3 | 5 3 4 2 1 |
| 2 | 0,226 | 1 | posiciones 1 y 2 | 3 5 4 2 1 |
Mostrar aquí la herramienta (barajar 1 2 3 4 5)
Son los mismos números que en el ejemplo 4.1: la herramienta usa la misma sucesión de números aleatorios en todas las pantallas con la misma semilla de población. En esa población de seis circuitos, el sexto individuo vuelve a ser 3 5 4 2 1. No es un error: con 5 ciudades solo hay 4!/2 = 12 circuitos distintos, y al sacar seis al azar es fácil que alguno se repita.
Hay formas de barajar que parecen equivalentes y no lo son. Una muy tentadora es intercambiar, en cada paso, la posición k con una posición cualquiera de 1 a n, en lugar de 1 a k.
Con n = 3, el procedimiento «para k = 1, 2, 3, intercambia la posición k con una posición j sorteada entre 1 y 3» usa tres sorteos de 3 valores cada uno. (a) ¿Cuántas sucesiones de sorteos distintas hay, todas igual de probables? ¿Cuántas permutaciones de 3 elementos? (b) ¿Puede salir cada permutación con la misma probabilidad? (c) ¿Cuántos sorteos usa Fisher–Yates con n = 3, y cuántas sucesiones distintas tiene?
Ver la solución
Hay 3^3 = 27 sucesiones y 3! = 6 permutaciones.
No. Para que las 6 permutaciones fueran igual de probables, cada una tendría que salir en el mismo número de sucesiones, y 27 no es divisible por 6. Haciendo las 27 cuentas, las permutaciones 1 3 2, 2 1 3 y 2 3 1 salen 5 veces cada una, y 1 2 3, 3 1 2 y 3 2 1, 4 veces.
Fisher–Yates hace dos sorteos: j entre 1 y 3 para k = 3 y j entre 1 y 2 para k = 2. Son 3 \times 2 = 6 sucesiones, una por permutación.
4.3 Diversidad y factibilidad de la población inicial BásicoB
¿Cómo se mide si una población es variada? ¿Y cuántos de sus individuos describen soluciones que se pueden llevar a cabo?
Para medir la diversidad se usa una distancia entre dos individuos, que la herramienta normaliza entre 0 (iguales) y 1 (lo más distintos posible):
- En las cadenas de bits y de enteros, la proporción de genes distintos, que es la distancia de Hamming dividida por la longitud.
- En el viajante, la proporción de tramos de un circuito que no están en el otro. Así, los 2n cromosomas de un mismo circuito están a distancia 0.
- Cuando el cromosoma es un vector de reales, como el punto de la caja [-5, 5]^2 del ejercicio 4.1, la distancia euclídea entre los dos puntos dividida por la longitud de la diagonal de la caja, que es la mayor distancia posible entre dos de sus puntos (10\sqrt{2} \approx 14{,}1 en ese caso).
Con ella se resume la población: la distancia media entre todos los pares, la distancia mínima (si es 0, hay dos individuos iguales) y el número de individuos distintos. Para individuos uniformes, la distancia media esperada es 0,5 en los bits, 1 - 1/m en los enteros y unos 0,37 en un punto de dos reales.
Que haya individuos repetidos no es raro. Con 64 cromosomas posibles y una población de 10, la probabilidad de que salgan todos distintos es \frac{64}{64} \times \frac{63}{64} \times \dots \times \frac{55}{64} \approx 0{,}48, menos de la mitad. Es la paradoja del cumpleaños: basta un grupo de 23 personas para que sea más probable que dos de ellas cumplan años el mismo día que lo contrario (Diaconis y Mosteller, 1989).
Hay algo más importante: una población uniforme sobre los cromosomas no es uniforme sobre las soluciones factibles. Si la mitad de los cromosomas no cumplen las restricciones, más o menos la mitad de la población inicial tampoco las cumplirá. Lo veremos con un problema de la mochila (capacidad W = 13) que usaremos en el resto del capítulo:
| Objeto | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Peso w_i | 4 | 3 | 5 | 8 | 4 | 2 |
| Valor v_i | 5 | 4 | 9 | 4 | 7 | 4 |
De sus 2^6 = 64 cromosomas, 34 caben en la mochila (el 53,1 %). El óptimo es 1 0 1 0 1 0: los objetos 1, 3 y 5, que pesan justo 13 y valen 21.
Datos. La mochila de la tabla y una población uniforme de N = 8 individuos:
| I1 | I2 | I3 | I4 | I5 | I6 | I7 | I8 |
|---|---|---|---|---|---|---|---|
| 011011 | 111101 | 100000 | 010010 | 001011 | 100100 | 111110 | 110110 |
Predice. ¿Cuántos caben en la mochila? ¿Cuál es el mejor de los que caben? ¿Hay dos individuos que se parezcan mucho?
Abrir: factibilidad Abrir: diversidad
Ver el resultado
| Individuo | Objetos | Peso | Valor | ¿Cabe? |
|---|---|---|---|---|
| I1 | 2, 3, 5, 6 | 14 | 24 | No |
| I2 | 1, 2, 3, 4, 6 | 22 | 26 | No |
| I3 | 1 | 4 | 5 | Sí |
| I4 | 2, 5 | 7 | 11 | Sí |
| I5 | 3, 5, 6 | 11 | 20 | Sí |
| I6 | 1, 4 | 12 | 9 | Sí |
| I7 | 1, 2, 3, 4, 5 | 24 | 29 | No |
| I8 | 1, 2, 4, 5 | 19 | 20 | No |
Mostrar aquí la herramienta (factibilidad)
En otras representaciones la diferencia es mucho mayor. En la asignación escrita como matriz binaria (sección 3.9), una fila tiene exactamente un 1 con probabilidad 3/8, y las cinco filas a la vez, con probabilidad (3/8)^5 \approx 0{,}0074: solo 243 de las 32 768 matrices son asignaciones válidas. Una población uniforme de 8 matrices tiene alguna válida con probabilidad 1 - (1 - 0{,}0074)^8 \approx 0{,}06. Con el vector de enteros o con la permutación, en cambio, todos los cromosomas son válidos: es una ventaja de esas representaciones.
Calcula las distancias normalizadas entre los tres primeros individuos del ejemplo 4.3: I1 = 011011, I2 = 111101 e I3 = 100000. ¿Cuánto valen la distancia media y la mínima de esa población de tres?
Ver la solución
- I1 e I2 se diferencian en los bits 1, 4 y 5: 3/6 = 0{,}5.
- I1 e I3 se diferencian en los bits 1, 2, 3, 5 y 6: 5/6 \approx 0{,}83.
- I2 e I3 se diferencian en los bits 2, 3, 4 y 6: 4/6 \approx 0{,}67.
Explorar en initialization-and-evaluation-ga
- Al final del paso a paso, mira la tabla Diversidad y calidad de la población. Pulsa Sortear la población varias veces: ¿cuánto varía la distancia media? ¿Y el número de factibles?
- Cambia a Asignación · matriz binaria y comprueba cuántos individuos son asignaciones válidas.
- Cambia a Viajante · permutación con 5 ciudades y 20 individuos. ¿Cuántos circuitos distintos salen?
4.4 Sembrar con una heurística: un contraejemplo BásicoB
Si ya tenemos una solución razonable, obtenida con otro método, ¿no conviene meterla en la población inicial?
Parece buena idea, y en métodos que parten de una sola solución, como la búsqueda local, es lo habitual. En un algoritmo genético hay que tener más cuidado. Lo habitual es generar la población inicial al azar; se pueden usar heurísticas, pero que compense o no depende del problema (Eiben y Smith, 2015, apartados 3.2.7 y 10.3.1). Surry y Radcliffe (1996) llamaron inoculación a sembrar la población inicial con buenas soluciones conocidas: en sus problemas industriales mejoraba la calidad media de los resultados y acortaba la búsqueda, pero el mejor resultado de varias ejecuciones podía empeorar, porque la población era menos aleatoria. Por eso los manuales advierten de que la convergencia prematura puede aparecer precisamente si la población inicial se genera con una heurística voraz o con una búsqueda local (Talbi, 2009, p. 193). El motivo es la diversidad. Una buena solución mezclada con individuos aleatorios, mucho peores, gana todas las comparaciones: la selección la copia una y otra vez, y en pocas generaciones sus copias ocupan toda la población. Si esa solución no es el óptimo, el algoritmo se queda atrapado cerca de ella.
Una heurística voraz construye una solución tomando en cada paso la decisión que parece mejor. En la mochila, se ordenan los objetos por su relación valor/peso, de mayor a menor, una idea que se remonta a Dantzig (1957), y se mete cada uno si cabe. En nuestra mochila, el orden es 6 (4/2 = 2), 3 (9/5 = 1,8), 5 (7/4 = 1,75), 2, 1 y 4. Entran el 6, el 3 y el 5, que pesan 11; los demás ya no caben. La solución voraz es 0 0 1 0 1 1, que vale 20: buena, pero no la óptima, que vale 21.
¿Cuánto tarda en invadir la población? Supongamos que hay k copias de la mejor solución entre N individuos y que solo actúa la selección por torneo binario con reemplazo, que elige dos individuos al azar y se queda con el mejor (lo verás en la sección 5.2). Un torneo deja escapar la solución solo si sus dos contendientes son otros, lo que ocurre con probabilidad (1 - k/N)^2. El número esperado de copias en la generación siguiente es k' = N\left[1 - \left(1 - \frac{k}{N}\right)^2\right]. El número de generaciones hasta que toda la población es la misma solución es el tiempo de toma de control (takeover time) (Goldberg y Deb, 1991).
Datos. La mochila de la sección 4.3, una población de N = 10 individuos: 9 aleatorios uniformes, el mejor de los cuales vale 18, y una copia de la solución voraz, 001011.
Predice. Con selección por torneo binario, sin cruce ni mutación, ¿cuántas copias de la solución voraz habrá de media tras cada generación? ¿En cuántas generaciones ocupará casi toda la población?
Ver el resultado
| Generación | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| Copias esperadas | 1 | 1,9 | 3,4 | 5,7 | 8,1 | 9,7 | 10,0 |
Mostrar aquí la herramienta (una copia sembrada)
A cualquier mejor individuo le pasaría lo mismo con la selección sola. La diferencia es qué invade la población. En una población aleatoria, los mejores individuos son solo algo mejores que los demás y se parecen poco entre sí, y el cruce y la mutación tienen tiempo de combinarlos antes de que uno domine. La semilla heurística, en cambio, es una solución elegida de antemano y muy superior al resto, que gana todos los torneos desde la primera generación.
Sembrar no está prohibido, pero tiene que ser una decisión consciente. Si se hace, conviene «aleatorizar» la heurística para obtener soluciones distintas, porque el principal inconveniente es que la población pierde diversidad y se estanca (Talbi, 2009, p. 198). En un primer diseño, lo recomendable es una población aleatoria uniforme.
- Con N = 10 y una copia, comprueba con la fórmula los valores de las generaciones 1, 2 y 3 del ejemplo 4.4. (b) ¿Cuántas copias esperadas hay tras una generación si se siembran 5 copias? (c) En la población del ejemplo, ¿qué objeto habría que cambiar en la solución voraz para llegar al óptimo?
Ver la solución
Generación 1: 10\,[1 - (0{,}9)^2] = 10 \times 0{,}19 = 1{,}9. Generación 2: 1 - 1{,}9/10 = 0{,}81 y 10\,[1 - 0{,}81^2] = 10 \times 0{,}3439 \approx 3{,}44. Generación 3: 1 - 0{,}3439 = 0{,}6561 y 10\,[1 - 0{,}6561^2] \approx 10 \times 0{,}5695 \approx 5{,}7.
10\,[1 - (0{,}5)^2] = 7{,}5 copias: tres cuartos de la población en una sola generación.
La solución voraz mete los objetos 3, 5 y 6 (001011) y el óptimo, los objetos 1, 3 y 5 (101010). Hay que cambiar dos genes a la vez: sacar el objeto 6 y meter el 1. Cambiando uno solo, o no cabe (meter el 1 sin sacar el 6 da peso 15) o se pierde valor (sacar el 6 deja 16).
Explorar en initialization-and-evaluation-ga
- Sube las Copias de la solución heurística (K) y observa en la etapa de Diversidad cómo bajan los individuos distintos.
- Cambia a Asignación · vector de enteros y a Viajante · permutación: la heurística es otra (cada tarea a la máquina en la que acabaría antes; el vecino más cercano). ¿Da el óptimo?
- Pulsa Nueva instancia hasta encontrar una mochila en la que la solución voraz sí es la óptima. ¿Cambia algo en la curva de copias?
4.5 Del cromosoma a la aptitud BásicoB
Una vez creada la población, ¿cómo sabe el algoritmo lo bueno que es cada individuo?
Evaluar un individuo es pasar de su cromosoma a un número, su aptitud (fitness), que dice lo bueno que es. La función objetivo asocia a cada solución un valor real que describe su calidad, y antes puede hacer falta una decodificación que pase del cromosoma a la solución (Eiben y Smith, 2015, apartado 3.2.2; Talbi, 2009, p. 43). La aptitud es lo único que ve la selección: dos individuos con la misma aptitud son igual de buenos para el algoritmo, aunque representen soluciones muy distintas.
La evaluación es una cadena de cuatro eslabones:
- Decodificar el genotipo en el fenotipo, la solución que representa (sección 3.1). En la mochila, cada 1 mete su objeto.
- Calcular el objetivo sobre esa solución, aunque no cumpla las restricciones. En la mochila, el valor total.
- Medir la violación de las restricciones: 0 si se cumplen y, si no, cuánto se incumplen. En la mochila, el exceso de peso e = \max(0,\ \text{peso} - W).
- Combinar las dos cosas en la aptitud. Si el individuo es factible, su aptitud es el objetivo. Si no, hay que decidir qué hacer con él. En esta sección usamos una penalización sencilla, la que usa la herramienta por defecto: F = \text{valor} - e. En la sección 4.7 veremos cómo elegirla.
Datos. La mochila de la sección 4.3 (W = 13) y el individuo I1 = 011011 del ejemplo 4.3. La aptitud de un infactible es F = \text{valor} - e.
Predice. ¿Qué objetos lleva? ¿Cuánto valen y cuánto pesan? ¿Cuál es su aptitud? ¿Será el mejor de la población por aptitud?
Abrir: aptitud de I1 Abrir: la población evaluada
Ver el resultado
- Decodificar: los unos están en las posiciones 2, 3, 5 y 6, así que lleva los objetos 2, 3, 5 y 6.
- Objetivo: valor = 4 + 9 + 7 + 4 = 24.
- Violación: peso = 3 + 5 + 4 + 2 = 14 > 13. No cabe, con un exceso e = 1.
- Aptitud: F = 24 - 1 = 23.
Mostrar aquí la herramienta (aptitud de I1)
El objetivo no siempre es la mejor guía. En los problemas de satisfacibilidad, por ejemplo, hay que encontrar valores de unas variables lógicas que hagan verdaderas todas las cláusulas de una fórmula. El objetivo natural vale 1 si la fórmula se cumple y 0 si no, y no distingue entre una solución a la que le falla una cláusula y otra a la que le fallan todas. Contar las cláusulas que se cumplen da una aptitud que sí guía la búsqueda, y es la base de muchos algoritmos evolutivos para este problema (Gottlieb et al., 2002; Talbi, 2009, p. 44).
La aptitud tampoco tiene por qué ser una fórmula. Puede ser el resultado de una simulación, de un experimento o de la valoración de una persona, y entonces cada evaluación es lenta y cara (Jin, 2005; Talbi, 2009, pp. 46–47). Cuando la aptitud la da una persona, por ejemplo al elegir entre diseños, imágenes o sonidos, se habla de computación evolutiva interactiva (Takagi, 2001).
Con la misma mochila y la misma aptitud, F = \text{valor} - e, evalúa I7 = 111110 e I8 = 110110. ¿Quedan por delante o por detrás de I5 = 001011, que vale 20?
Ver la solución
I7 lleva los objetos 1–5: valor 5 + 4 + 9 + 4 + 7 = 29, peso 4 + 3 + 5 + 8 + 4 = 24, exceso e = 11 y F = 29 - 11 = 18.
I8 lleva los objetos 1, 2, 4 y 5: valor 5 + 4 + 4 + 7 = 20, peso 4 + 3 + 8 + 4 = 19, exceso e = 6 y F = 20 - 6 = 14.
Los dos quedan por detrás de I5 (20). Con esta penalización, el problema es I1: se pasa solo una unidad de peso, pero vale mucho.Explorar en initialization-and-evaluation-ga
- Avanza por las etapas Decodificar, Objetivo y restricciones y Aptitud y escribe cada eslabón del primer individuo antes de verlo.
- Cambia a Función 2D · cadena binaria: ¿qué hace ahora el eslabón de decodificar? Compáralo con el ejemplo 3.1.
- Cambia a Asignación · matriz binaria: ¿cómo se mide ahí la violación?
4.6 Minimizar un coste: del objetivo a la aptitud BásicoB
Volvamos a la asignación de la sección 4.1: hay que repartir 5 tareas entre 3 máquinas que trabajan a la vez. La carga de una máquina es la suma de los tiempos de sus tareas, y el makespan es la mayor de las cargas, el momento en que termina la última máquina; queremos que sea lo más pequeño posible. El problema se explica con detalle en la sección 3.4. ¿Puede servir el makespan, tal cual, como aptitud?
Depende de cómo se elijan los padres. Una forma muy usada es la ruleta, que da a cada individuo una probabilidad de ser elegido proporcional a su aptitud, p_i = \frac{F_i}{\sum_j F_j}, y que estudiarás en la sección 5.3. Para ella, la aptitud tiene que cumplir dos condiciones: cuanto mayor, mejor, y nunca negativa. Un coste que se minimiza no cumple la primera. En investigación operativa, para pasar de minimizar a maximizar basta con cambiar el signo, F = -f, pero así las aptitudes salen negativas y la ruleta no se puede construir (Goldberg, 1989, pp. 75–76). Hay varias transformaciones que conservan el orden y dan aptitudes no negativas:
- F = C - f, con C el mayor coste de la población actual (o de las últimas generaciones, o un valor fijo). Es la que propone Goldberg (1989, p. 76). El peor individuo recibe F = 0 y no sale nunca en la ruleta.
- F = 1/(1 + f), siempre positiva si f \ge 0.
- La aptitud por rango: se ordenan los individuos del peor (puesto 1) al mejor (puesto N), y F es el puesto; si hay empates, la media de los puestos. Solo usa el orden, no los valores (Talbi, 2009, p. 206). Es la idea de la selección por rango de Baker (1985), que evita que un individuo extraordinario se lleve casi toda la ruleta y mantiene la presión cuando las aptitudes se parecen (Mitchell, 1996/1998, apartado 5.4). La verás, con sus variantes, en la sección 5.7.
Si el problema es de maximizar pero el objetivo puede ser negativo, como el valor de una mochila tras restarle una penalización, Goldberg propone sumar una constante, F = u + C, con C el valor absoluto del peor (Goldberg, 1989, p. 76).
Datos. La población del ejemplo 4.1, con makespans f = 21, 9, 8, 14, 14 y 14 (individuos I1 a I6).
Predice. Con F = C - f, ¿qué probabilidad de salir en una tirada tiene el mejor, I3? ¿Y con el rango? ¿Qué le pasa al peor, I1?
Abrir: F = C − f Abrir: F = 1/(1 + f) Abrir: rango
Ver el resultado
Con C = 21, las aptitudes C - f son 0, 12, 13, 7, 7 y 7, que suman 46. Con el rango, los tres empatados con 14 ocupan los puestos 2, 3 y 4 y reciben la media, 3; la suma es 21.
| Individuo | f | C - f | p | 1/(1+f) | p | Rango | p |
|---|---|---|---|---|---|---|---|
| I1 | 21 | 0 | 0 % | 0,045 | 10,0 % | 1 | 4,8 % |
| I2 | 9 | 12 | 26,1 % | 0,100 | 21,9 % | 5 | 23,8 % |
| I3 | 8 | 13 | 28,3 % | 0,111 | 24,3 % | 6 | 28,6 % |
| I4, I5, I6 | 14 | 7 | 15,2 % | 0,067 | 14,6 % | 3 | 14,3 % |
Mostrar aquí la herramienta (F = C − f)
Las cuatro transformaciones conservan el orden. Una selección que solo compara individuos, como el torneo, elegiría exactamente igual con cualquiera de ellas; con la ruleta, en cambio, elegir la aptitud es elegir la presión selectiva: cuánto favorece la selección a los mejores. Demasiada lleva a la convergencia prematura; demasiado poca, a una búsqueda casi al azar. Volveremos a ello en los capítulos 5 y 9.
Supón que todos los makespans del ejemplo 4.6 llevaran sumados 100 unidades de tiempo de preparación, iguales en todas las soluciones: 121, 109, 108, 114, 114 y 114. El problema es el mismo. (a) Con F = 1/(1 + f), ¿cuántas veces más probable es el mejor que el peor? Compáralo con el 2,4 del problema original. (b) ¿Cambian las probabilidades con C - f? ¿Y con el rango?
Ver la solución
El cociente entre la aptitud del mejor y la del peor es (1 + 121)/(1 + 108) = 122/109 \approx 1{,}12, frente a 22/9 \approx 2{,}4 antes. Sumar una constante, que no cambia el problema, casi anula la presión selectiva.
Con C - f, C pasa a ser 121 y las aptitudes siguen siendo 0, 12, 13, 7, 7 y 7: no cambia nada, porque solo cuentan las diferencias. Con el rango tampoco, porque el orden es el mismo. Es el mismo fenómeno que verás en la sección 5.4 con la ruleta.
Explorar en initialization-and-evaluation-ga
- Cambia la Aptitud a partir del coste f a F = -f y lee lo que pasa en la etapa Ruleta.
- En la tabla Las cuatro transformaciones con esta población, compara la columna Mejor / peor. ¿Cuál reparte la ruleta de forma más igualada?
- Cambia a Viajante · permutación. Las longitudes de los circuitos son números grandes y parecidos: ¿qué le ocurre a 1/(1 + f)?
4.7 Restricciones como penalización BásicoB
En el ejemplo 4.5, un individuo que no cabe en la mochila ganó a todos los que caben. ¿Cuánto hay que castigar a un infactible?
Cuando la representación produce soluciones que no cumplen las restricciones, hay varias estrategias: rechazarlas, repararlas, usar un decodificador o preservar la factibilidad con los operadores, como vimos en la sección 3.10; o dejarlas en la población con una aptitud peor. Esta última, la penalización, es la más usada (Coello Coello, 2002; Talbi, 2009, p. 49). El objetivo se amplía con un término que crece con la violación: F = \text{valor} - P \quad \text{(maximizar)}, \qquad F = f + P \quad \text{(minimizar)}.
Hay dos decisiones. La primera es cómo medir la violación. Contar cuántas restricciones se incumplen no dice si la solución está cerca de ser factible. Ya Richardson et al. (1989) recomendaron penalizar con una distancia a la factibilidad, que da una idea de lo que costaría repararla (Talbi, 2009, p. 50). En la mochila, el exceso de peso e. La segunda es la forma y el peso del término:
- Lineal, P = \lambda\, e: cada unidad de exceso cuesta λ unidades de valor.
- Cuadrática, P = (\lambda\, e)^2: un exceso pequeño casi no se castiga y uno grande, mucho.
El peso λ es la decisión difícil. Si es demasiado pequeño, la búsqueda puede terminar en soluciones infactibles; si es demasiado grande, puede converger a soluciones factibles que no son óptimas (Michalewicz y Schoenauer, 1996, apartado 3.2.6; Talbi, 2009, p. 50), porque los infactibles quedan todos al fondo y se pierden los que están cerca del límite. Y es ahí, en la frontera de la región factible, donde suele estar el óptimo cuando alguna restricción está activa; Schoenauer y Michalewicz (1996) propusieron incluso buscar solo en esa frontera. Para una población concreta se puede calcular el peso crítico λ*: el menor peso con el que ningún infactible iguala ni supera al mejor factible. Si B es el valor del mejor factible, cada infactible con valor z_i > B y exceso e_i queda por detrás si z_i - \lambda e_i < B, así que, con la penalización lineal, \lambda^* = \max_i \frac{z_i - B}{e_i}.
Datos. La población del ejemplo 4.3. Los cuatro infactibles son:
| Individuo | Valor z_i | Peso | Exceso e_i |
|---|---|---|---|
| I1 = 011011 | 24 | 14 | 1 |
| I2 = 111101 | 26 | 22 | 9 |
| I7 = 111110 | 29 | 24 | 11 |
| I8 = 110110 | 20 | 19 | 6 |
El mejor factible es I5 = 001011, con B = 20.
Predice. Con la penalización lineal, ¿cuánto vale λ*? ¿Quién es el mejor con λ = 1 y con λ = 5?
Abrir: λ = 1 Abrir: λ = 5 Abrir: el peso crítico
Ver el resultado
| Individuo | (z_i - B)/e_i |
|---|---|
| I1 | (24 - 20)/1 = 4 |
| I2 | (26 - 20)/9 \approx 0{,}67 |
| I7 | (29 - 20)/11 \approx 0{,}82 |
| I8 | (20 - 20)/6 = 0 |
Mostrar aquí la herramienta (el peso crítico)
La figura 4.1 dibuja la aptitud de los ocho individuos según λ. Los factibles son líneas horizontales; los infactibles bajan, más deprisa cuanto mayor es su exceso.
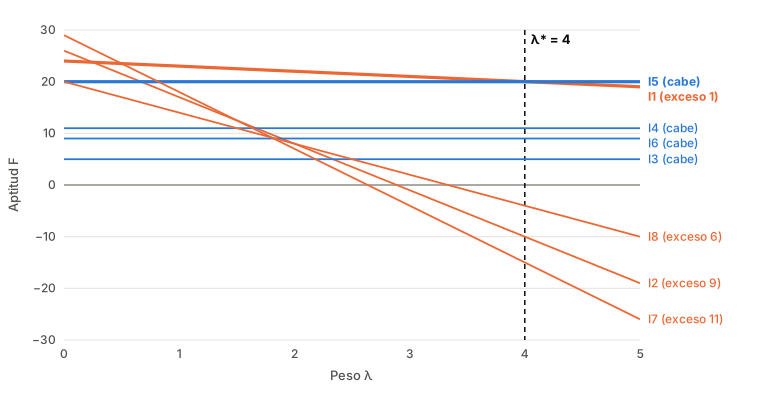
figuras/04-inicializar-evaluar.py, en el repositorio del libro.
Ver los datos de la figura
| Individuo | ¿Cabe? | Aptitud con λ | λ = 0 | λ = 1 | λ = 4 | λ = 5 |
|---|---|---|---|---|---|---|
| I1 | No | 24 - \lambda | 24 | 23 | 20 | 19 |
| I2 | No | 26 - 9\lambda | 26 | 17 | −10 | −19 |
| I3 | Sí | 5 | 5 | 5 | 5 | 5 |
| I4 | Sí | 11 | 11 | 11 | 11 | 11 |
| I5 | Sí | 20 | 20 | 20 | 20 | 20 |
| I6 | Sí | 9 | 9 | 9 | 9 | 9 |
| I7 | No | 29 - 11\lambda | 29 | 18 | −15 | −26 |
| I8 | No | 20 - 6\lambda | 20 | 14 | −4 | −10 |
λ* depende de la población, que cambia en cada generación. Por eso existen penalizaciones dinámicas, cuyo peso crece con las generaciones (Joines y Houck, 1994), y adaptativas, que lo ajustan según lo que va encontrando la búsqueda; por ejemplo, subiéndolo si el mejor individuo de las últimas generaciones ha sido siempre infactible y bajándolo si ha sido siempre factible (Hadj-Alouane y Bean, 1997; Michalewicz y Schoenauer, 1996, apartado 3.2.4; Talbi, 2009, pp. 50–51). Otros métodos evitan elegir λ. En el torneo de Deb (2000), un factible gana siempre a un infactible; entre dos factibles gana el de mejor objetivo, y entre dos infactibles, el que menos incumple las restricciones. Además, con λ = 5 la aptitud de I2, I7 e I8 es negativa: si se quisiera usar la ruleta, habría que sumar una constante, como en la sección 4.6.
Con la misma población y la penalización cuadrática, F = \text{valor} - (\lambda\, e)^2: (a) ¿cuánto vale el peso crítico? (b) Con λ = 3, ¿cuál es la aptitud de I1 y quién es el mejor? (c) Con la penalización lineal y λ = 2, ¿quién es el mejor?
Ver la solución
I1 queda por detrás de I5 si 24 - (\lambda \times 1)^2 < 20, es decir, si \lambda^2 > 4: \lambda^* = \sqrt{4}/1 = 2. Para los demás infactibles, \sqrt{z_i - B}/e_i vale \sqrt{6}/9 \approx 0{,}27, \sqrt{9}/11 \approx 0{,}27 y 0. El peso crítico es 2.
F = 24 - 3^2 = 15. Los otros infactibles quedan muy abajo (por ejemplo, I2: 26 - 27^2 = -703). El mejor es I5, con 20.
Con la lineal, λ = 2 está por debajo de λ* = 4: I1 tiene F = 24 - 2 = 22 > 20 y sigue siendo el mejor.
Explorar en initialization-and-evaluation-ga
- Mueve el Peso λ y fíjate en la tabla Penalización en esta población: ¿en qué valor cambia el mejor individuo?
- Cambia la Penalización a cuadrática y compara la forma de las líneas en la etapa El peso λ.
- Cambia a Asignación · matriz binaria, donde se minimiza. Si la población no tiene ningún factible, ¿qué pasa con λ*?
4.8 El coste de evaluar BásicoB
Hasta ahora hemos evaluado una población. ¿Cuánto cuesta evaluar a lo largo de toda una ejecución?
En muchos problemas, evaluar es lo que más tiempo consume de una metaheurística (Jin, 2005; Talbi, 2009, p. 47). En el diseño aerodinámico, por ejemplo, evaluar una estructura es ejecutar una simulación de dinámica de fluidos que puede durar más de un día, incluso en un ordenador paralelo (Talbi, 2009, p. 47). Seleccionar, cruzar y mutar cuesta muy poco a su lado.
Un algoritmo genético generacional evalúa los N individuos de cada generación. Con G generaciones, contando la población inicial, son N\,(G + 1) evaluaciones. Ese número es el presupuesto del algoritmo. Para comparar dos algoritmos de forma justa se cuentan evaluaciones, no generaciones ni segundos de un ordenador concreto (Eiben y Smith, 2015, apartado 9.2); por eso un número máximo de evaluaciones es uno de los criterios de parada habituales (sección 8.6).
Muchas de esas evaluaciones se repiten. La selección copia a los buenos individuos, y la mutación deja a muchos hijos iguales que su padre: con una probabilidad de mutación de 1/L por gen, un hijo sale sin ningún cambio con probabilidad (1 - 1/L)^L, que se acerca a 1/e \approx 0{,}37 cuando L crece. Una caché, una tabla que guarda el cromosoma y su aptitud, evita volver a evaluar un individuo ya visto: antes de evaluar, se busca en la tabla (Kratica, 1999).
Datos. La población del ejemplo 4.3 (N = 8) evoluciona G = 6 generaciones con un algoritmo mínimo: torneo binario y mutación de cada gen con probabilidad 1/L (1/6 con 6 objetos), sin cruce. Se cuentan las evaluaciones sin caché y con caché.
Predice. ¿Cuál es el presupuesto? ¿Cuántas evaluaciones crees que ahorra la caché? Con el mismo presupuesto, ¿hasta qué generación se podría llegar con caché? ¿Ahorraría lo mismo con una mochila de 12 objetos?
Abrir: 6 objetos Abrir: 12 objetos
Ver el resultado
El presupuesto es 8 \times (6 + 1) = 56 evaluaciones. Con la caché, la mochila de 6 objetos solo necesita 25: se ahorran 31 (el 55 %). Con el mismo presupuesto de 56 se llegaría hasta la generación 55, porque solo hay 64 cromosomas distintos y la caché nunca puede necesitar más de 64 evaluaciones. Es un caso extremo: con 12 objetos (2^{12} = 4\,096 cromosomas), la caché necesita 40 evaluaciones, ahorra 16 (el 29 %) y permite llegar a la generación 9.Mostrar aquí la herramienta (6 objetos)
La caché tiene condiciones. Solo vale si la aptitud es determinista, es decir, si evaluar dos veces el mismo individuo da lo mismo; lo veremos en la sección 4.13. Ocupa memoria, una entrada por cada individuo distinto. Y la clave importa: en el viajante, los 2n cromosomas de un mismo circuito tienen la misma longitud, y una caché por circuito ahorraría más que una por cromosoma. Otras formas de ahorrar son evaluar en paralelo o sustituir parte de las evaluaciones por un modelo aproximado, que verás en las ampliaciones.
- Un algoritmo con N = 50 individuos se ejecuta durante 100 generaciones. ¿Cuántas evaluaciones hace? Si cada una es una simulación de un minuto, ¿cuánto tarda? (b) Con mutación de probabilidad 1/L por gen, ¿qué probabilidad tiene un hijo de salir sin ningún cambio si L = 6? ¿Y si L = 100?
Ver la solución
50 \times 101 = 5\,050 evaluaciones, unos 5 050 minutos: más de 84 horas, casi tres días y medio sin parar.
Con L = 6, (5/6)^6 \approx 0{,}33. Con L = 100, (0{,}99)^{100} \approx 0{,}37. En los dos casos, alrededor de un tercio de los hijos que no se cruzan son copias exactas de su padre.
Explorar en initialization-and-evaluation-ga
- Avanza generación a generación y anota cuántos individuos ya estaban en la caché. ¿Aumentan o disminuyen?
- Cambia las Generaciones (G) y el Problema y codificación. ¿En qué problema ahorra menos la caché?
4.9 Cubrir mejor la caja: cuasialeatoria e hipercubo latino AvanzadoA
Una población uniforme reparte los individuos por igual en promedio. ¿Lo hace también en cada población concreta, cuando solo hay ocho?
No. Con pocos individuos, el azar deja huecos grandes en unas zonas y amontona individuos en otras. Si cada eje de la caja se divide en N franjas iguales, un punto al azar cae fuera de una franja dada con probabilidad 1 - 1/N, y N puntos la dejan vacía con probabilidad (1 - 1/N)^N. Con N = 8, eso es 0,34: en promedio, un tercio de las franjas de cada eje quedan vacías. Cuando N crece, esa probabilidad se acerca a 1/e \approx 0{,}37.
Hay dos familias de métodos que reparten mejor la población (Kazimipour et al., 2014; Talbi, 2009, pp. 194–196):
- Las secuencias cuasialeatorias, o de baja discrepancia (Niederreiter, 1992), no solo buscan que los números sean independientes, sino también que se dispersen: cada punto nuevo cae en los huecos que dejan los anteriores. En general, dan más diversidad que los números pseudoaleatorios (Talbi, 2009, p. 195). La de Halton (1960) usa, en cada coordenada, el inverso radical de i en una base prima distinta (2 y 3 en el plano): se escribe i en esa base y se dan la vuelta a sus cifras detrás de la coma. En base 2, i = 1, 2, 3, 4 dan 0,5; 0,25; 0,75 y 0,125: primero la mitad, luego los cuartos que faltan, luego los octavos. La de Sobol (1967) usa la base 2 en todas las coordenadas, combinadas de otra forma. Las dos son deterministas: dan siempre la misma población. Maaranen et al. (2004) las usaron para generar la población inicial de un algoritmo genético.
- El muestreo por hipercubo latino (McKay et al., 1979) sí es aleatorio. Cada eje se divide en N estratos iguales, y dos permutaciones al azar deciden en qué estrato cae cada individuo en cada eje; dentro del estrato, la posición se sortea. Así, cada estrato de cada eje recibe exactamente un individuo, como N torres en un tablero de N \times N que no se amenazan. Talbi lo presenta como un ejemplo de diversificación en paralelo, porque genera todas las soluciones a la vez y de forma independiente, sin evaluar la función objetivo (Talbi, 2009, pp. 195–196).
Datos. La función de Himmelblau en la caja [-5, 5]^2 y N = 8 individuos de la secuencia de Halton, con x_j = -5 + 10\,u_j, redondeado a centésimas. La herramienta los compara con la población uniforme de 8 individuos de la misma semilla.
Predice. ¿Qué puntos dan i = 1, 2, 3 y 4? ¿Cuántas de las 8 franjas de cada eje ocupa Halton? ¿Y la población uniforme?
Abrir: el segundo punto Abrir: las franjas ocupadas
Ver el resultado
| i | En base 2 | u_1 | En base 3 | u_2 | Punto |
|---|---|---|---|---|---|
| 1 | 1 | 0,1₂ = 0,5 | 1 | 0,1₃ = 1/3 | (0,00; −1,67) |
| 2 | 10 | 0,01₂ = 0,25 | 2 | 0,2₃ = 2/3 | (−2,50; 1,67) |
| 3 | 11 | 0,11₂ = 0,75 | 10 | 0,01₃ = 1/9 | (2,50; −3,89) |
| 4 | 100 | 0,001₂ = 0,125 | 11 | 0,11₃ = 4/9 | (−3,75; −0,56) |
Mostrar aquí la herramienta (las franjas ocupadas)
La figura 4.2 compara las tres poblaciones de ocho individuos.
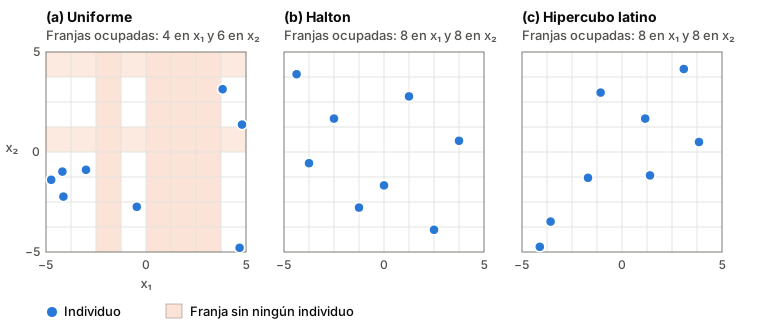
figuras/04-inicializar-evaluar.py, en el repositorio del libro, con los puntos que da initialization-and-evaluation-ga con la semilla de población 1.
Ver los datos de la figura
| Individuo | Uniforme | Halton | Hipercubo latino |
|---|---|---|---|
| 1 | (−4,13; −2,23) | (0,00; −1,67) | (3,85; 0,50) |
| 2 | (−0,46; −2,74) | (−2,50; 1,67) | (1,40; −1,17) |
| 3 | (4,80; 1,37) | (2,50; −3,89) | (1,16; 1,67) |
| 4 | (4,68; −4,79) | (−3,75; −0,56) | (−1,07; 2,97) |
| 5 | (−3,00; −0,89) | (1,25; 2,78) | (3,09; 4,15) |
| 6 | (−4,74; −1,39) | (−1,25; −2,78) | (−1,70; −1,29) |
| 7 | (3,83; 3,14) | (3,75; 0,56) | (−3,57; −3,48) |
| 8 | (−4,18; −0,98) | (−4,37; 3,89) | (−4,11; −4,74) |
En un algoritmo genético, la ventaja es modesta y se nota sobre todo con poblaciones pequeñas y problemas continuos de pocas variables. Hay comparaciones experimentales en Maaranen et al. (2004) y en la revisión de Kazimipour et al. (2014). El hipercubo latino no garantiza que el plano quede bien cubierto: los ocho puntos podrían caer en la diagonal y seguirían ocupando todas las franjas. Y Halton y Sobol, tal como están, dan siempre la misma población, así que para hacer varias ejecuciones independientes (sección 9.3) hay que aleatorizarlos.
Calcula u_1 y u_2 de la secuencia de Halton para i = 5, 6 y 7, y los puntos correspondientes en [-5, 5]^2.
Ver la solución
| i | En base 2 | u_1 | En base 3 | u_2 | Punto |
|---|---|---|---|---|---|
| 5 | 101 | 0,101₂ = 5/8 = 0,625 | 12 | 0,21₃ = 2/3 + 1/9 = 7/9 | (1,25; 2,78) |
| 6 | 110 | 0,011₂ = 3/8 = 0,375 | 20 | 0,02₃ = 2/9 | (−1,25; −2,78) |
| 7 | 111 | 0,111₂ = 7/8 = 0,875 | 21 | 0,12₃ = 1/3 + 2/9 = 5/9 | (3,75; 0,56) |
Explorar en initialization-and-evaluation-ga
- Cambia el Método a Secuencia de Sobol y a Hipercubo latino, y compara las franjas ocupadas y el mayor hueco.
- Con Halton, pulsa Sortear la población: ¿cambia algo? ¿Y con el hipercubo latino?
- Pulsa Comparar estrategias: la herramienta genera 1 000 poblaciones con cada estrategia. ¿Cuál ocupa más franjas de media? ¿Y cuál da el mejor individuo inicial?
4.10 Diversificación secuencial AvanzadoA
En la población del ejemplo 4.1, los individuos I4 = (2, 1, 1, 3, 1) e I6 = (3, 1, 1, 3, 1) solo se diferencian en un gen. ¿Se puede impedir que entren dos individuos tan parecidos?
En una diversificación secuencial, las soluciones se generan una tras otra de forma que la diversidad se optimice (Talbi, 2009, p. 195). La más sencilla es la inhibición secuencial simple (simple sequential inhibition, SSI). Viene de la estadística espacial, donde sirve para generar patrones de puntos que no pueden estar demasiado cerca unos de otros (Diggle, 1983), y en un algoritmo genético funciona así: se genera un candidato al azar, con la regla uniforme, y solo entra en la población si está a una distancia de al menos δ de todos los individuos que ya están; si no, se descarta y se genera otro. Se repite hasta completar la población (Talbi, 2009, p. 195).
Así, la población final tiene, por construcción, una distancia mínima entre individuos de δ o más. El inconveniente es el coste, relativamente alto, y que no se sabe de antemano cuántos candidatos harán falta (Talbi, 2009, p. 195). Si δ es demasiado grande para el tamaño del espacio y de la población, puede que no quepan N individuos tan separados y el proceso no termine; la herramienta, tras 50N candidatos, acepta los siguientes sin comprobar la distancia. En la práctica, δ se elige algo por debajo de la distancia media de una población uniforme. A diferencia de las secuencias cuasialeatorias y del hipercubo latino, solo necesita una distancia, así que vale para cualquier representación.
Datos. La asignación de la sección 4.1, N = 6 y δ = 0,6: dos individuos tienen que diferenciarse en al menos 3 de sus 5 genes. Los candidatos salen en el mismo orden que la población del ejemplo 4.1: (1, 1, 2, 1, 3), (2, 3, 1, 1, 2), (1, 2, 3, 3, 1), (2, 1, 1, 3, 1), (1, 2, 2, 1, 2), (3, 1, 1, 3, 1)…
Predice. ¿Cuáles de esos seis candidatos entran en la población? ¿Cuántos candidatos crees que harán falta en total?
Abrir: el quinto candidato Abrir: el coste
Ver el resultado
Entran los cuatro primeros: el más cercano a cada uno de los ya aceptados está a 0,80, 0,80 y 0,60. El quinto, (1, 2, 2, 1, 2), está a 0,40 de I1 (se diferencian en las tareas 2 y 5) y se descarta. El sexto, (3, 1, 1, 3, 1), está a 0,20 del cuarto y también se descarta. Hacen falta 11 candidatos para reunir 6 individuos: se descartan 5. La distancia mínima de la población pasa de 0,20 en la uniforme a 0,60, y la media, de 0,71 a 0,76.Mostrar aquí la herramienta (el coste)
La inhibición secuencial no mira la calidad de los individuos ni reparte la población de forma pareja por todo el espacio: solo impide que dos individuos estén demasiado cerca.
- Calcula la distancia del quinto candidato del ejemplo 4.10, (1, 2, 2, 1, 2), a cada uno de los cuatro individuos aceptados. (b) ¿Habría entrado con δ = 0,4? (c) ¿Con qué valores de δ la población sería exactamente la uniforme del ejemplo 4.1?
Ver la solución
Frente a I1 = (1, 1, 2, 1, 3) cambian las tareas 2 y 5: 2/5 = 0{,}4. Frente a I2 = (2, 3, 1, 1, 2) cambian las tareas 1, 2 y 3: 0,6. Frente a I3 = (1, 2, 3, 3, 1) cambian las tareas 3, 4 y 5: 0,6. Frente a I4 = (2, 1, 1, 3, 1), las cinco: 1. La más cercana es 0,4.
Sí: 0,4 ≥ 0,4.
La población uniforme es la de los seis primeros candidatos, y su distancia mínima es 0,20 (entre el cuarto y el sexto). Con cualquier δ de 0,20 o menos, los seis primeros candidatos entran y la población es la uniforme, porque la regla es «al menos δ». Con δ = 0, la inhibición secuencial es la inicialización uniforme.
4.11 Inicialización factible AvanzadoA
Si con algunas representaciones casi todos los cromosomas al azar son infactibles, ¿se puede generar directamente una población que cumpla las restricciones?
Sí, si se cambia lo que se sortea. En la mochila, se baraja el orden de los objetos con Fisher–Yates (sección 4.2) y se recorren en ese orden, metiendo cada uno si cabe en lo que queda de capacidad. El resultado siempre es factible y, además, está lleno: no cabe ningún objeto más. Chu y Beasley (1998) usaron una inicialización de este tipo en su algoritmo genético para la mochila multidimensional. En la matriz binaria de la asignación basta con sortear la máquina de cada tarea, j = 1 + \lfloor u\,m \rfloor, y poner un único 1 en esa columna de la fila: es la inicialización uniforme del vector de enteros, escrita como matriz. La factibilidad de la población inicial depende tanto de la representación como del método.
Inicializar de forma factible no es gratis. La mochila llena sesga la población: nunca salen soluciones con pocos objetos, que son factibles y pueden tener genes valiosos, y los individuos se parecen más entre sí. Y en problemas con restricciones complicadas, encontrar una sola solución factible puede ser tan difícil como resolver el problema; entonces es más práctico tratar las restricciones al evaluar, con penalizaciones (sección 4.7), o con reparaciones y decodificadores (sección 3.10). Rechazar los infactibles solo es razonable si son una parte muy pequeña del espacio de búsqueda (Talbi, 2009, p. 49).
Datos. La mochila de la sección 4.3 (W = 13). Para el primer individuo, el orden barajado de los objetos es 2, 4, 3, 5, 1, 6.
Predice. ¿Qué objetos entran? ¿Cuánto pesa y cuánto vale la mochila? ¿Está llena?
Abrir: el primer individuo Abrir: la calidad de la población
Ver el resultado
| Objeto | Peso | Peso acumulado | ¿Entra? |
|---|---|---|---|
| 2 | 3 | 3 | Sí |
| 4 | 8 | 11 | Sí |
| 3 | 5 | 16 | No |
| 5 | 4 | 15 | No |
| 1 | 4 | 15 | No |
| 6 | 2 | 13 | Sí |
Mostrar aquí la herramienta (el primer individuo)
La pantalla «Comparar estrategias» de la herramienta repite cada estrategia en 1 000 poblaciones de la misma mochila, con N = 8. De media, la inicialización factible da un 100 % de factibles (frente al 53 % de la uniforme) y un mejor individuo inicial de 20,4 (frente a 17,3), pero solo el 68 % de individuos distintos (frente al 95 %). Sembrar media población con la solución voraz da un 61 % de distintos y una distancia mínima de 0. La inhibición secuencial es la única que sube la diversidad, a cambio de generar 1,6 veces más candidatos.
Con la misma mochila: (a) ¿qué individuo sale si el orden barajado es 3, 5, 1, 2, 6, 4? (b) ¿Puede salir el individuo 1 0 0 0 0 0 con esta inicialización? (c) ¿Y la solución voraz, 0 0 1 0 1 1?
Ver la solución
Entran el 3 (peso 5), el 5 (9) y el 1 (13); el 2, el 6 y el 4 ya no caben. Sale 1 0 1 0 1 0, el óptimo.
No: con solo el objeto 1 (peso 4) todavía caben otros, y el procedimiento los habría metido. Solo salen mochilas llenas.
Sí. Con los objetos 3, 5 y 6 la mochila pesa 11 y le quedan 2 unidades libres, en las que no cabe ningún otro objeto (el más ligero que falta pesa 3): está llena. Sale, por ejemplo, con el orden 6, 3, 5, 1, 2, 4.
Explorar en initialization-and-evaluation-ga
- Cambia a Asignación · matriz binaria y compara la factibilidad con la de la inicialización uniforme.
- Abre Comparar estrategias con esta mochila y busca la estrategia con más individuos distintos y la que da el mejor individuo inicial. ¿Coinciden?
4.12 Paisaje de aptitud AvanzadoA
Hay problemas en los que unos pocos cambios llevan siempre al óptimo y otros en los que cualquier búsqueda se queda atascada. ¿De qué depende?
Si se imagina cada cromosoma a una altura igual a su aptitud, aparecen valles, picos, mesetas y acantilados: es el paisaje de aptitud (fitness landscape). La idea viene de la genética de poblaciones: la propuso Wright (1932) para estudiar la evolución (Talbi, 2009, p. 104). Lo definen tres cosas: la representación, la vecindad, que dice qué cromosomas se alcanzan desde uno con un cambio pequeño, y la función objetivo (Stadler, 2002; Talbi, 2009, p. 104). El paisaje no es, por tanto, una propiedad del problema solo: con otra representación u otra vecindad, el mismo problema tiene otro paisaje.
Un óptimo local es un cromosoma sin ningún vecino mejor. Una búsqueda local que pasa siempre al mejor vecino acaba en el óptimo local de la cuenca en la que empezó. Si hay muchos óptimos locales (un paisaje rugoso), cada punto de partida acaba en uno distinto y casi nunca en el óptimo global (Kauffman y Levin, 1987). Un algoritmo genético se mueve por el paisaje con una población entera, y el cruce puede saltar entre cuencas, pero la forma del paisaje sigue decidiendo lo difícil que es el problema; por eso una población inicial diversa empieza en muchas cuencas a la vez.
Para resumir la forma del paisaje sin dibujarlo, Jones y Forrest (1995) propusieron la correlación aptitud-distancia (FDC): la correlación entre la aptitud de muchos cromosomas y su distancia al óptimo global más cercano (Talbi, 2009, pp. 114–115). En un problema de minimizar, una correlación positiva y grande indica un problema relativamente fácil (al acercarse al óptimo, la aptitud mejora); una negativa y grande, un problema engañoso; y una cercana a cero, que la aptitud no orienta. Su gran limitación es que hay que conocer el óptimo, lo que no es realista en muchos problemas (Talbi, 2009, p. 115). Malan y Engelbrecht (2013) revisan otras medidas del paisaje, como la autocorrelación de la aptitud a lo largo de un camino aleatorio, que no necesitan conocerlo.
Datos. La asignación de la sección 4.1 y su vecindad a un gen: dos asignaciones son vecinas si se pasa de una a otra moviendo una tarea a otra máquina. La búsqueda local parte de I1 = (1, 1, 2, 1, 3), con makespan 21, y en cada paso pasa al mejor vecino.
Predice. ¿Cuántos vecinos tiene cada asignación? ¿Cuántos son mejores que I1? ¿Llegará la búsqueda local al óptimo, 5?
Abrir: los vecinos de I1 Abrir: la búsqueda local
Ver el resultado
Cada tarea puede ir a otras dos máquinas: 5 \times 2 = 10 vecinos. De los vecinos de I1, 6 son mejores; el mejor pasa la tarea 2 a la máquina 2 y baja el makespan a 12. La búsqueda local sigue así:
| Paso | Asignación | Movimiento | Makespan |
|---|---|---|---|
| 0 | (1, 1, 2, 1, 3) | 21 | |
| 1 | (1, 2, 2, 1, 3) | tarea 2 a la máquina 2 | 12 |
| 2 | (1, 2, 2, 3, 3) | tarea 4 a la máquina 3 | 11 |
| 3 | (1, 2, 1, 3, 3) | tarea 3 a la máquina 1 | 7 |
Mostrar aquí la herramienta (la búsqueda local)
Comprueba que la asignación (1, 2, 1, 3, 3), donde termina la búsqueda del ejemplo 4.12, es un óptimo local. (a) Calcula sus cargas. (b) ¿Qué tarea habría que mover para bajar de 7? ¿Basta con mover una? (c) ¿Cuántos de sus vecinos tienen también makespan 7?
Ver la solución
La máquina 1 hace las tareas 1 y 3: 5 + 2 = 7. La 2 hace la tarea 2: 2. La 3 hace las tareas 4 y 5: 1 + 5 = 6. El makespan es 7.
Para bajar de 7 hay que aliviar la máquina 1, sacando la tarea 1 o la 3. Si la tarea 1 va a la máquina 2, esta pasa a 2 + 5 = 7; si va a la 3, a 6 + 8 = 14. Si la tarea 3 va a la máquina 2, esta pasa a 2 + 9 = 11; si va a la 3, a 6 + 1 = 7. Ningún movimiento de una sola tarea baja de 7, así que es un óptimo local. Para llegar al óptimo, (1, 2, 3, 3, 2), hay que mover dos tareas: la 3 a la máquina 3 y la 5 a la 2.
Cuatro vecinos tienen también makespan 7: la tarea 1 a la máquina 2, la 3 a la 3, la 4 a la 2 y la 5 a la 2. Es una meseta: la búsqueda local que solo acepta vecinos mejores se para en ella.
Explorar en initialization-and-evaluation-ga
- Con la función de Himmelblau, mira cuántas búsquedas locales llegan a un mínimo. Cambia la Función a Rastrigin y repite. ¿Cuál de los dos paisajes es rugoso?
- Cambia a Función 2D · cadena binaria: con la misma función, ¿cuántos óptimos locales aparecen ahora? Recuerda los saltos de la sección 3.8.
4.13 Aptitud con ruido AvanzadoA
¿Qué pasa si evaluar dos veces el mismo individuo no da el mismo número?
En muchos problemas reales, los datos tienen ruido. Ocurre cuando la aptitud sale de un simulador estocástico o de un sensor, o cuando los datos son inciertos, como los tiempos de proceso variables en una planificación o las demandas aleatorias en una ruta (Talbi, 2009, p. 15). Se puede escribir como \tilde F(x) = f(x) + z, con z un ruido que se suele suponer normal, de media 0 y desviación σ. En la práctica, se aproxima con la media de varias evaluaciones (Talbi, 2009, p. 15).
Con ruido, la selección compara números que no son la aptitud real. Si la diferencia real Δ entre dos individuos es pequeña frente a σ, su orden aparente es casi una moneda al aire. La media de R evaluaciones tiene el mismo valor esperado y una desviación \sigma/\sqrt{R}, así que la diferencia entre las medias de dos individuos tiene desviación \sigma\sqrt{2/R} y los dos se ordenan mal con probabilidad \Phi\!\left(-\frac{\Delta\sqrt{R}}{\sigma\sqrt{2}}\right), donde Φ es la función de distribución de la normal estándar. Reevaluar cuesta: N individuos con R evaluaciones cada uno son N \times R evaluaciones por generación, y para reducir el error a la mitad hacen falta cuatro veces más.
Datos. Una población uniforme de 8 puntos de la función de Himmelblau, que se minimiza. Los dos mejores son I1, con aptitud real 52,555, e I7, con 91,112: una diferencia Δ ≈ 38,56. Cada evaluación suma un ruido normal de σ = 30. Se compara una evaluación por individuo con la media de R = 5.
Predice. ¿Con qué probabilidad quedan mal ordenados I1 e I7 con una evaluación? ¿Y con la media de 5? ¿Cuántas evaluaciones cuesta cada opción?
Ver el resultado
Con una evaluación, \Delta/(\sigma\sqrt 2) = 38{,}56/42{,}43 \approx 0{,}91 y \Phi(-0{,}91) \approx 18,2 %. Con la media de 5, el argumento se multiplica por \sqrt 5: \Phi(-2{,}03) \approx 2,1 %. El precio son 40 evaluaciones en lugar de 8. Para bajar del 5 % basta con 4 evaluaciones por individuo. En esta población, los pares mal ordenados bajan de 5 a 2 de los 28.Mostrar aquí la herramienta (el coste)
El ruido cambia otras decisiones. La caché de la sección 4.8 ya no sirve, porque guardaría para siempre una evaluación con suerte; el elitismo (sección 8.3) puede quedarse con un individuo que solo parecía bueno; y conviene evaluar la solución final varias veces antes de darla por buena. Hay alternativas más baratas que reevaluar a todos, como aumentar el tamaño de la población, que promedia el ruido de forma implícita, o reevaluar solo a los individuos cuyas comparaciones están reñidas; Jin y Branke (2005) revisan estas técnicas.
Con los datos del ejemplo 4.13 (Δ = 38,56, σ = 30), ¿cuántas evaluaciones por individuo hacen falta para que I1 e I7 se ordenen mal con una probabilidad menor del 5 %? Usa que \Phi(-1{,}645) = 0{,}05.
Ver la solución
Hace falta \Delta\sqrt{R}/(\sigma\sqrt 2) \ge 1{,}645, es decir, 0{,}909\,\sqrt R \ge 1{,}645, \sqrt R \ge 1{,}81 y R \ge 3{,}27. Como R es entero, R = 4. Con N = 8, son 32 evaluaciones por generación en lugar de 8.Explorar en initialization-and-evaluation-ga
- Cambia el Ruido (σ) y las Evaluaciones por individuo (R), y observa cuántos pares quedan mal ordenados.
- Cambia a Viajante · permutación: ¿qué σ hace falta para que el mejor aparente deje de ser el real?
4.14 Ampliaciones Para saber más+
Aptitud aproximada. Cuando una evaluación cuesta horas, se puede sustituir parte de ellas por un metamodelo: una función barata que aproxima la función objetivo a partir de una muestra de soluciones ya evaluadas. También se llama modelo sustituto (surrogate) o aptitud aproximada. Redes neuronales, superficies de respuesta, kriging o procesos gaussianos son metamodelos habituales (Jin, 2005, 2011; Talbi, 2009, pp. 47–48). El compromiso es el de siempre: una evaluación exacta y cara frente a una barata y con error, y se pueden alternar las dos (Talbi, 2009, p. 48). Un uso típico es la preselección: el metamodelo elige, de muchos candidatos, los que parecen mejores, y solo esos se evalúan de verdad. En la pantalla «Aptitud aproximada» de la herramienta, un metamodelo de ponderación por la inversa de la distancia, construido con los 8 individuos de la población inicial, ordena regular 8 candidatos nuevos (correlación de rangos de 0,26), pero si se evalúan de verdad solo los 4 que estima mejores, se ahorran 4 evaluaciones y entre ellos está el mejor candidato real.
Varios objetivos. Muchos problemas reales tienen objetivos en conflicto: una mochila con más valor pesa más. Entonces no hay una solución mejor que todas, sino un conjunto de compromisos. Una solución domina a otra si no es peor en ningún objetivo y es mejor en alguno; las soluciones a las que no domina ninguna son óptimos de Pareto (Deb, 2001; Talbi, 2009, p. 311). Hay dos formas de evaluar. La suma ponderada normaliza los objetivos y los combina con unos pesos, lo que convierte el problema en uno de un solo objetivo; su inconveniente es que solo encuentra soluciones soportadas, y las que están en una parte no convexa del frente no las elige ningún peso (Talbi, 2009, pp. 324–325). La alternativa es asignar la aptitud según la dominancia: los no dominados forman el primer frente; si se quitan, los no dominados que quedan forman el segundo, y así sucesivamente. En la pantalla «Varios objetivos», con la población del ejemplo 4.3 y la mochila sin capacidad (el valor se maximiza y el peso se minimiza), el primer frente tiene 6 individuos, y 2 de ellos no los elige ningún peso.
Sin la restricción de capacidad, cada individuo del ejemplo 4.3 tiene dos objetivos: el valor, que se maximiza, y el peso, que se minimiza. ¿Qué individuos están dominados, y por quién?
Ver la solución
Los pares (valor; peso) son: I1 (24; 14), I2 (26; 22), I3 (5; 4), I4 (11; 7), I5 (20; 11), I6 (9; 12), I7 (29; 24) e I8 (20; 19). Están dominados I6, por I4 (más valor y menos peso) y por I5, e I8, por I5 (el mismo valor y menos peso) y por I1. Los otros seis forman el primer frente.La historia de los algoritmos genéticos con varios objetivos, de los primeros a los más recientes, y las lecturas para seguir están en el apartado «Varios objetivos» de la sección 11.5.
Una población diversa por construcción. Se puede plantear la generación de la población inicial como un problema de optimización: elegir N soluciones que maximicen una medida de diversidad, como la menor distancia entre dos de ellas. Puede ser tan difícil como el problema original, así que se resuelve de forma aproximada, por ejemplo generando primero una parte de la población al azar y añadiendo después, una a una, las soluciones más alejadas de las que ya hay (Talbi, 2009, pp. 194, 197–198).
Aptitudes relativas. En algunos problemas no hay un valor absoluto que medir, como en un juego en el que la estrategia A gana a la B, la B a la C y la C a la A. Entonces la aptitud se obtiene comparando a los individuos entre sí, por puesto o mediante competiciones, y a los algoritmos de población les basta, porque la selección solo necesita saber quién es mejor (Talbi, 2009, p. 47).
Más lecturas. Kazimipour et al. (2014) revisan las técnicas de inicialización de la población en algoritmos evolutivos, y Coello Coello (2002), las formas de tratar las restricciones.
Resumen
- La población inicial se genera al azar y de forma uniforme: los bits, los enteros y los reales, gen a gen; las permutaciones, barajando con Fisher–Yates. No tiene que ser buena, sino diversa.
- La diversidad se mide con distancias normalizadas entre individuos. Una población uniforme sobre los cromosomas no es uniforme sobre las soluciones factibles: puede tener muchos infactibles.
- Sembrar la población con una solución heurística es un contraejemplo: la selección la copia y, en pocas generaciones, la población pierde la diversidad.
- Evaluar es decodificar, calcular el objetivo, medir la violación y combinarlo todo en la aptitud. Con una penalización, el peso λ no debe ser ni demasiado pequeño, porque ganan los infactibles, ni demasiado grande.
- Para la ruleta, un coste se transforma en aptitud (C - f, 1/(1 + f) o el rango): todas conservan el orden, pero reparten la ruleta de forma distinta. El esfuerzo se mide en evaluaciones, N\,(G + 1), y una caché evita repetirlas si la aptitud es determinista.