9 Parámetros y aleatoriedad
Herramientas: EvoTraveller y SelectionMechanisms, accesibles desde el portal. Las dos están en inglés.
Al terminar el recorrido básico de este capítulo podrás:
- explicar por qué dos ejecuciones del mismo algoritmo genético dan resultados distintos y qué papel tiene la semilla;
- calcular la media y la desviación típica de varias ejecuciones e interpretarlas;
- decidir si la diferencia entre dos configuraciones es creíble o puede deberse al azar;
- explicar por qué no hay valores de Pc y pm buenos para todos los problemas y cómo se ajustan con casos parecidos al real;
- relacionar la presión selectiva con la pérdida de diversidad y con la mutación.
9.1 Un algoritmo que depende del azar BásicoB
Si ejecutamos dos veces el mismo algoritmo genético, ¿obtenemos la misma solución?
Un algoritmo genético usa números aleatorios en casi todos sus pasos: para crear la población inicial, para elegir a los padres (capítulo 5), para decidir si una pareja se cruza y por dónde (capítulo 6) y para decidir qué individuos mutan y cómo (capítulo 7). Es un algoritmo estocástico: con los mismos datos y los mismos parámetros, cada ejecución puede acabar en un sitio distinto.
En un ordenador, los números «aleatorios» los produce un generador que parte de un valor inicial, la semilla. Con la misma semilla, el generador da siempre la misma secuencia y la ejecución se repite idéntica; con otra semilla, es otra ejecución. Fijar la semilla sirve para reproducir un resultado, pero no lo convierte en más fiable: es una ejecución entre muchas posibles.
EvoTraveller resuelve el problema del viajante con un algoritmo genético. Hay un origen en la posición (0, 0) y varios lugares repartidos por una cuadrícula; el algoritmo busca la ruta más corta que pasa por todos y vuelve al origen. Cada individuo es una permutación de los lugares, y su aptitud (fitness) es la inversa de la longitud de la ruta, así que a mayor aptitud, ruta más corta. Aplica torneo, cruce y mutación de permutaciones y reemplazo generacional con élite, como en los capítulos anteriores. Con 10 lugares, el origen y otros 9, hay 9! = 362 880 rutas posibles. Un programa aparte las revisa todas y nos dice cuál es la mejor, de longitud 31,50. Con ese dato podemos medir a qué distancia del óptimo queda el algoritmo.
Datos. En EvoTraveller, deja los valores iniciales: Number of places 10, Seed 1111, Population size 100, Generations 50, Tournament size 4, Mutation rate 0,05, Elitism 0,05 y Crossover 0,6. Pulsa Run.
Predice. ¿Encuentra el algoritmo la mejor ruta posible, de longitud 31,50? Si pulsas Run otra vez sin cambiar nada, ¿qué ruta saldrá?
Abrir y configurar: EvoTraveller
Ver el resultado
La curva Fitness sube de 0,0230 en la generación 0 a 0,0293 al final, y deja de mejorar hacia la generación 3. La inversa de esos valores es la longitud de la ruta: de 43,45 a 34,11. El óptimo es 31,50, así que la ruta encontrada es un 8,3 % más larga.
Al pulsar Run otra vez, sale exactamente la misma ruta: la semilla es la misma y el generador repite la misma secuencia de números.Cambia solo la Seed a 1112 y pulsa Run. ¿Qué ha cambiado: solo los números aleatorios del algoritmo o también el problema? ¿Qué consecuencia tiene para comparar dos ejecuciones con semillas distintas?
Ver la solución
En EvoTraveller la semilla fija tanto los números aleatorios del algoritmo como las posiciones de los lugares, así que con otra semilla cambia también el mapa: es otro problema, y su mejor ruta puede ser más larga o más corta. Comparar dos ejecuciones con semillas distintas mezcla el efecto del azar del algoritmo con la dificultad de cada mapa. Para comparar dos configuraciones hay que usar la misma semilla, y por tanto el mismo mapa, y cambiar solo el parámetro.9.2 Probabilidad de cruce y de mutación BásicoB
¿Cuánto hay que cruzar y cuánto mutar?
Los capítulos 6 y 7 presentaron dos parámetros que controlan cuánto cambia la población en cada generación. La probabilidad de cruce Pc es la de que una pareja de padres se cruce; si no se cruza, sus hijos son copias de los padres. La probabilidad de mutación pm es la de que un gen o, en una permutación, un individuo mute (Eiben y Smith, 2015). En EvoTraveller, Mutation rate es pm: cada individuo, salvo la élite, muta con esa probabilidad, con un intercambio de dos lugares. Crossover hace el papel de Pc: es la fracción de la población que se forma por cruce; el resto son copias de los padres, que también pueden mutar. La élite (Elitism) es otra fracción de la población, que pasa sin cambios. Son dos de los parámetros del algoritmo, junto con el tamaño de la población, el del torneo o el de la élite.
Recuerda que pm no significa lo mismo en todas las representaciones. Con bits, pm es la probabilidad de que mute cada gen. Los valores habituales son pequeños, de 0,001 a 0,01, o \mathit{pm} = 1/k, donde k es el número de genes, para que en promedio mute uno solo en cada individuo (Talbi, 2009, p. 208). Lo vimos en la sección 7.7. En EvoTraveller, en cambio, pm es la probabilidad de que el individuo reciba un intercambio, que cambia dos posiciones. En promedio, cada hijo cambia 2 \times \mathit{pm} posiciones: con pm = 0,05, una décima de posición; con pm = 0,5, una posición, como pide la regla 1/k. Para comparar valores de pm entre representaciones hay que traducirlos a cuántos genes cambian, en promedio, en cada hijo.
Datos. El mismo problema del ejemplo 9.1, con todos los valores iniciales salvo Mutation rate, que tomará tres valores: 0, 0,05 y 0,2. Pulsa Run con cada uno.
Predice. ¿Con qué valor acaba la ruta más corta? ¿Y la más larga?
Abrir y configurar: EvoTraveller
Ver el resultado
| Mutation rate | Aptitud final | Longitud final | Sobre el óptimo (31,50) |
|---|---|---|---|
| 0 | 0,0261 | 38,34 | +21,7 % |
| 0,05 | 0,0293 | 34,11 | +8,3 % |
| 0,2 | 0,0317 | 31,50 | 0 % |
Pero cuidado: es una ejecución con cada valor. Que 0,2 haya ganado aquí no nos dice que sea mejor en general. Lo veremos en las próximas secciones.
En el ejemplo 9.2, sin mutación, la mejor aptitud deja de mejorar hacia la generación 5. ¿Por qué no sigue mejorando, si el cruce sigue combinando rutas?
Ver la solución
La selección solo copia rutas que ya existen, y el cruce de permutaciones solo reordena lo que traen los padres. Sin mutación, cuando la población se llena de copias de unas pocas rutas, se cruzan individuos casi idénticos y los hijos se parecen a sus padres: no entra ninguna variación nueva. La mutación es la única fuente de cambios que no depende de lo que ya hay en la población (sección 7.1).9.3 Una ejecución no basta BásicoB
Si el resultado depende del azar, ¿cómo sabemos qué da un algoritmo genético en general?
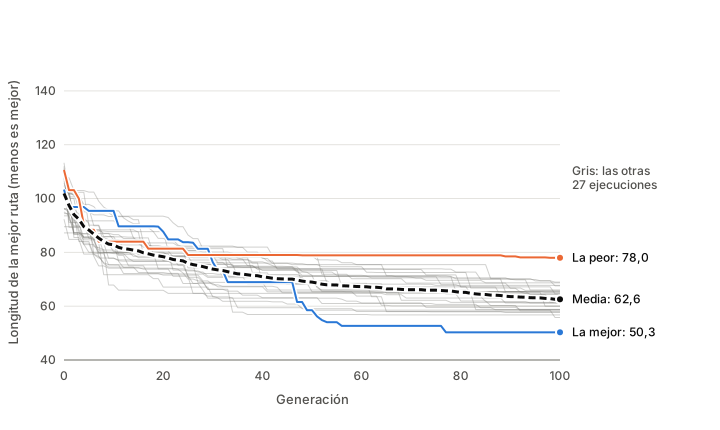
Repitiendo la ejecución. Cada repetición con una semilla distinta es una réplica, y lo que nos interesa es cómo se reparten los resultados de muchas réplicas. EvoTraveller no permite repetir ejecuciones sobre el mismo mapa, porque la semilla cambia también el mapa. Por eso hemos programado un algoritmo del mismo diseño: permutaciones, torneo de 3, cruce OX con Pc = 0,6, intercambio con pm = 0,05 por individuo y reemplazo generacional con un individuo de élite. Lo hemos aplicado a un mapa con 20 destinos y el origen, donde empieza y acaba la ruta: 21 ciudades en total. En EvoTraveller, Number of places cuenta también el origen, así que este mapa serían 21 lugares, más de los 15 que admite. Hemos usado una población de 30 y 100 generaciones. Un solo mapa, 30 semillas distintas (1 a 30).
figuras/09-experimentos.py, en el repositorio del libro.
Ver los datos de la figura
Longitud final de la mejor ruta en las 30 ejecuciones, de menor a mayor: 50,3; 55,8; 56,8; 57,6; 57,9; 58,3; 58,7; 58,7; 58,8; 60,0; 60,0; 61,1; 61,2; 61,4; 61,5; 62,5; 63,4; 64,4; 64,6; 64,7; 65,1; 65,4; 65,4; 65,9; 66,0; 67,6; 67,7; 68,7; 69,0; 78,0.
La media de la longitud de la mejor ruta pasa de 101,9 en la generación 0 a 68,9 en la 50 y a 62,6 en la 100.Todas las ejecuciones mejoran, y deprisa al principio. Pero no acaban en el mismo sitio: la mejor termina en 50,3 y la peor en 78,0. Con una sola ejecución, el resultado habría sido uno cualquiera de esos treinta.
Para resumir muchas réplicas se usan dos números. La media es el resultado típico y la desviación típica mide cuánto se alejan de él las réplicas:
\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i, \qquad s = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n} (x_i - \bar{x})^2}
donde x_i es el resultado de la réplica i y n, el número de réplicas. En nuestras 30 réplicas, la media de la longitud final es 62,6 y la desviación típica, 5,2. Una desviación típica pequeña indica que el algoritmo es robusto: da resultados parecidos aunque cambie el azar (Talbi, 2009, p. 63). Si la dispersión es grande, una ejecución concreta puede salir mucho peor que la media, y quien la usa no lo sabe.
Datos. En EvoTraveller, con Number of places 15 y los demás valores iniciales, haz una ejecución con cada semilla, de 1111 a 1115, y con cada Mutation rate: 0, 0,05 y 0,2. Son 15 ejecuciones. La tabla del resultado da la longitud final; la aptitud es su inversa.
Predice. ¿Gana siempre el 0,2 a los otros dos? ¿Y el 0,05 al 0?
Abrir y configurar: EvoTraveller
Ver el resultado
| Semilla | Óptimo | Mutation rate 0 | 0,05 | 0,2 |
|---|---|---|---|---|
| 1111 | 37,04 | 47,64 | 43,08 | 38,46 |
| 1112 | 39,81 | 46,98 | 46,52 | 45,72 |
| 1113 | 32,31 | 41,28 | 37,29 | 35,40 |
| 1114 | 34,49 | 43,84 | 38,99 | 37,03 |
| 1115 | 38,38 | 40,86 | 44,90 | 39,53 |
| Media | 44,12 | 42,16 | 39,23 |
Las cinco primeras réplicas de la figura 9.1, con las semillas 1 a 5, terminan en 66,0; 56,8; 61,2; 58,7 y 57,9. Calcula su media y su desviación típica. Compáralas con las de las 30 réplicas (62,6 y 5,2). ¿Qué habría pasado si solo hubieras hecho la ejecución de la semilla 1?
Ver la solución
La media es (66{,}0 + 56{,}8 + 61{,}2 + 58{,}7 + 57{,}9)/5 = 60{,}12. Las desviaciones respecto a la media son 5,88; −3,32; 1,08; −1,42 y −2,22, y sus cuadrados suman 53,7. Dividido entre n - 1 = 4, da 13,4, y la raíz cuadrada es la desviación típica: 3,7.
Con cinco réplicas la media sale algo por debajo de la de 30 (60,1 frente a 62,6) y la desviación típica, algo más pequeña (3,7 frente a 5,2): con pocas réplicas, las estimaciones son poco fiables. Con la semilla 1 habríamos obtenido 66,0, que queda por encima de la media de las 30 réplicas: habríamos creído que el algoritmo da rutas más largas de lo habitual.9.4 Comparar dos configuraciones BásicoB
Si una configuración da una media menor que otra, ¿es mejor?
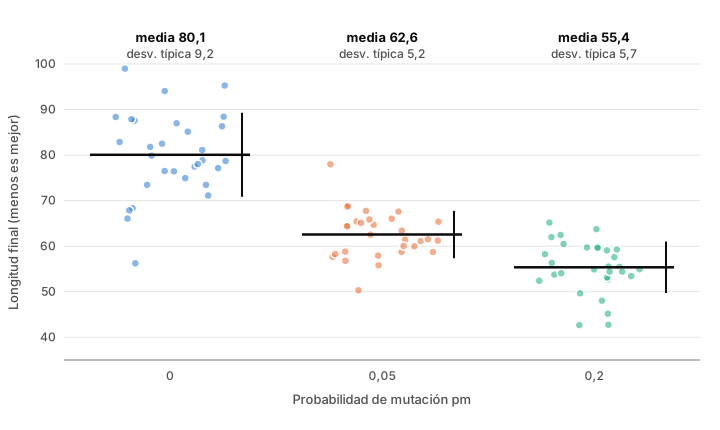
Con el mismo mapa y las mismas 30 semillas hemos repetido el experimento con tres valores de pm: 0, 0,05 y 0,2. Todas usan el mismo mapa y las mismas 30 semillas, y por tanto las mismas 30 poblaciones iniciales.
figuras/09-experimentos.py, en el repositorio del libro.
Ver los datos de la figura
| pm | Media | Desviación típica | Mínimo | Máximo |
|---|---|---|---|---|
| 0 | 80,1 | 9,2 | 56,2 | 99,0 |
| 0,05 | 62,6 | 5,2 | 50,3 | 78,0 |
| 0,2 | 55,4 | 5,7 | 42,7 | 65,2 |
La diferencia entre 0 y 0,05 es grande en comparación con la dispersión de las nubes. La diferencia entre 0,05 y 0,2 es menor y las nubes se solapan, pero sigue siendo clara: la media baja de 62,6 a 55,4. Como las tres configuraciones usan las mismas semillas, cada semilla forma una pareja: dos ejecuciones que parten de la misma población inicial y solo se diferencian en pm. La comparación natural se hace dentro de cada pareja. Con 0,05, la ruta final es más corta que con 0,2 en 3 de las 30 semillas, el 10 %; sin mutación, es más corta que con 0,05 en 1 de las 30.
También podemos preguntarnos qué le pasaría a quien hiciera una sola ejecución de cada configuración, con semillas distintas para cada una. Para simularlo, combinamos cada ejecución con 0,05 con cada ejecución con 0,2: 30 × 30 = 900 parejas. En 146 de ellas, el 16 %, la ejecución con 0,05 acaba con una ruta más corta. Y la ejecución sin mutación supera a la de 0,05 en el 5 % de las 900 parejas (47).
Si hubiéramos hecho una sola ejecución con cada valor, nos habría salido que 0,05 es mejor que 0,2, cuando no lo es, en una de cada diez comparaciones con la misma semilla y en una de cada seis con semillas distintas. Con 30 réplicas, la media de cada una tiene un error mucho menor, y la conclusión es fiable. Comparar medias de varias réplicas, y no ejecuciones sueltas, es lo que hace creíble una comparación.
Hay una condición más: la comparación solo vale para lo que se ha probado. Aquí, para este mapa, este tamaño de población y estas 100 generaciones. Sobre otros casos no sabemos nada aún; volveremos a ello en la sección 9.5.
Un compañero compara pm = 0,05 y pm = 0,2 con una sola ejecución de cada una, con semillas distintas elegidas al azar. Según las 900 parejas de la sección 9.4, ¿con qué frecuencia le saldrá que 0,05 es mejor? ¿Y si usa la misma semilla para las dos? ¿Y si compara las medias de 30 réplicas?
Ver la solución
Con una ejecución de cada una, 0,05 queda mejor en 146 de 900 parejas, el 16 %: se equivocaría una vez de cada seis, aproximadamente. Con la misma semilla, 0,05 queda mejor en 3 de las 30 semillas: una vez de cada diez. Con las medias de 30 réplicas, las medias son 62,6 y 55,4: la diferencia es de 7,2 y la ventaja de 0,2 se mantiene. En la sección 9.8 veremos cómo medir si esa diferencia es creíble.9.5 Ajustar con casos parecidos BásicoB
¿Qué valores de Pc y de pm conviene usar en un problema nuevo?
No hay una receta universal. Los valores adecuados dependen sobre todo del problema, incluso de la instancia concreta, y del tiempo de búsqueda que se quiera dedicar; no existe un conjunto de valores óptimo para todos los casos (Talbi, 2009, p. 54). Los primeros estudios sistemáticos dieron combinaciones que se usaron mucho. De Jong, con una batería de funciones de prueba, encontró que lo mejor era una población de 50 a 100 individuos, una Pc de 0,6 por pareja y una pm de 0,001 por bit. Grefenstette, con un algoritmo genético que ajustaba los parámetros de otro, obtuvo una población de 30, Pc = 0,95 y pm = 0,01. Y Schaffer y sus colaboradores, tras probar muchas combinaciones, una población de 20 a 30, Pc entre 0,75 y 0,95 y pm entre 0,005 y 0,01. Pero esos valores se obtuvieron con baterías concretas de problemas, y no se sabe cuánto valen fuera de ellas (Mitchell, 1996/1998, apartado 5.6). Y ya hemos visto que pm se define de otra manera en una permutación.
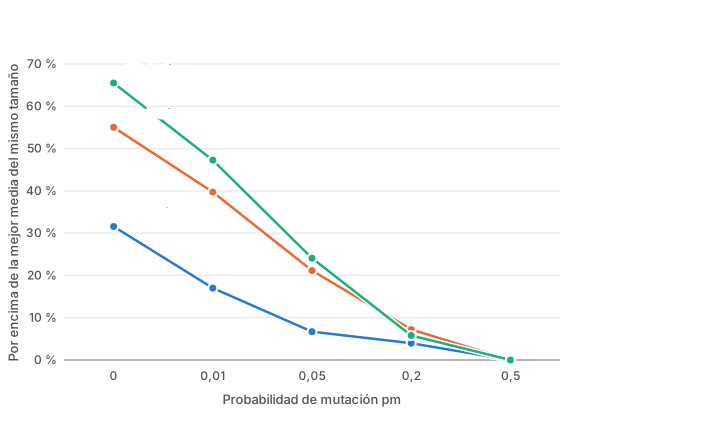
Para ver hasta qué punto depende del problema, hemos repetido el experimento con tres tamaños: 10, 20 y 30 destinos, más el origen, un mapa de cada tamaño, 30 réplicas por valor de pm. En la figura 9.3 no se muestran longitudes, porque no son comparables entre mapas. Para cada tamaño se muestra cuánto más larga es la media de cada valor de pm que la del mejor de los cinco valores probados.
figuras/09-experimentos.py, en el repositorio del libro.
Ver los datos de la figura
Media de la longitud final de 30 ejecuciones y, entre paréntesis, el porcentaje por encima de la mejor media del mismo mapa:
| pm | 10 destinos | 20 destinos | 30 destinos |
|---|---|---|---|
| 0 | 41,8 (+32 %) | 80,1 (+55 %) | 123,9 (+66 %) |
| 0,01 | 37,2 (+17 %) | 72,1 (+40 %) | 110,3 (+47 %) |
| 0,05 | 33,9 (+7 %) | 62,6 (+21 %) | 92,9 (+24 %) |
| 0,2 | 33,0 (+4 %) | 55,4 (+7 %) | 79,2 (+6 %) |
| 0,5 | 31,8 (0 %) | 51,6 (0 %) | 74,9 (0 %) |
Lo que muestra la figura es que el mismo valor de pm sale peor parado cuanto mayor es el problema. Con pm = 0,05, la media queda un 7 % por encima de la mejor con 10 destinos, un 21 % con 20 y un 24 % con 30. De los cinco valores probados, el mejor es el mismo en los tres tamaños: 0,5. No es un valor extraño: como vimos en la sección 9.2, equivale a cambiar en promedio una posición por hijo, lo que pide la regla 1/k, y 0,05 equivale a mutar diez veces menos. EvoTraveller solo llega a 0,2. En la sección 9.9 veremos por qué este algoritmo admite tanta mutación. Si hubiéramos ajustado pm con el problema de 10 destinos, habríamos creído que 0,05 está cerca del mejor, y en el problema de 30 destinos no lo está.
De ahí sale una regla práctica: ajustar los parámetros con casos parecidos al real, en tamaño y en estructura, y no con un caso pequeño y cómodo. Y mejor con varios casos que con uno solo. Esto tiene un límite que veremos en las ampliaciones: si ajustamos los parámetros con unos casos y evaluamos el algoritmo con los mismos, el resultado es demasiado optimista.
Tienes un problema real de 30 destinos, pero para ajustar pm solo usas el de 10, porque es más rápido. Con los datos de la figura 9.3, ¿qué diferencia ves entre pm = 0,05 y pm = 0,2 en cada tamaño? ¿Qué decisión tomarías con el caso pequeño y qué pasaría con el real?
Ver la solución
Con 10 destinos, 0,05 y 0,2 quedan un 7 % y un 4 % por encima de la mejor media: solo 3 puntos de diferencia. Con 30 destinos quedan un 24 % y un 6 %: 18 puntos. Con el caso pequeño, la diferencia parece menor y podríamos quedarnos con 0,05, el valor habitual. Aplicado al problema de 30 destinos, perderíamos mucho más: la ruta saldría de media un 24 % más larga que con el mejor valor probado. El problema pequeño subestima cuánto importa pm.- Con Number of places 10 y Mutation rate 0,05, haz una ejecución con cada semilla, de 1111 a 1115. Repite con Mutation rate 0,2. ¿En cuántas semillas mejora la ruta? Con 10 lugares, pasar de 0,05 a 0,2 mejora la ruta solo en 2 de las 5 semillas (1111 y 1114); en las otras 3 la ruta final es la misma.
- Haz lo mismo con Number of places 15. En las cinco semillas, 0,2 da una ruta más corta que 0,05. Cuanto mayor es el problema, más se nota el valor de pm.
9.6 ¿Qué buscas? BásicoB
¿Qué es un buen resultado: la mejor solución posible o una solución buena enseguida?
Al ajustar un algoritmo hay dos medidas en juego: la calidad de la solución y el tiempo de búsqueda. Qué importa más depende del problema. Talbi distingue tres clases según cuánto pesa cada una (Talbi, 2009, pp. 33–34):
- Problemas de diseño o estratégicos. Se resuelven una sola vez, el tiempo disponible es grande (horas, días, meses) y una solución mala tiene consecuencias duraderas, por ejemplo el diseño de una red de telecomunicaciones. Importa la calidad, y se justifica gastar mucho en buscar.
- Problemas de control u operativos. Hay que resolverlos con frecuencia y en tiempo real, con decisiones de fracciones de segundo, por ejemplo el encaminamiento de mensajes en una red. Hacen falta heurísticas muy rápidas, y la calidad importa menos.
- Problemas de planificación o tácticos. Están entre los dos extremos, a medio plazo. Hay que equilibrar calidad y tiempo.
Esto se traduce en parámetros. En un algoritmo genético, una población mayor o más generaciones cuestan más evaluaciones y, por tanto, más tiempo, y repetir la ejecución para tener réplicas multiplica el coste. El mismo algoritmo con valores distintos puede ser adecuado para un problema de diseño y no servir en uno operativo. Por eso, antes de ajustar parámetros hay que preguntarse cuánto tiempo hay y qué calidad se necesita. Las dos preguntas determinan qué es un «buen» valor.
Clasifica cada caso como estratégico, táctico u operativo y di si primaría la calidad o el tiempo: (a) diseñar una vez la red de comunicaciones de una empresa; (b) calcular cada semana las rutas de reparto de una empresa; (c) decidir en fracciones de segundo por qué enlace se envía cada mensaje en una red.
Ver la solución
- Es estratégico: se resuelve una vez, hay tiempo y un error pesa mucho durante años. Prima la calidad y se pueden permitir muchas réplicas y mucha población. (b) Es táctico: se repite cada semana y hay que equilibrar el tiempo de cálculo con la calidad de las rutas. (c) Es operativo: hay que decidir en tiempo real, así que prima el tiempo y se necesita una heurística muy rápida; un algoritmo genético con muchas generaciones no es adecuado aquí.
9.7 Presión selectiva y diversidad BásicoB
Si elegimos siempre a los mejores, ¿qué le pasa a la población?
La presión selectiva mide cuánto favorece la selección a los mejores (capítulo 5). Con presión alta, la población se llena enseguida de copias de unos pocos individuos y pierde diversidad: se llega a una convergencia prematura, que atasca la búsqueda en una zona del espacio sin explorar las demás. Con presión baja, la evolución es lenta. Hay que equilibrar la selección con la variación que traen el cruce y la mutación (Mitchell, 1996/1998, apartado 5.4); lo que importa no es el cruce o la mutación por separado, sino el equilibrio entre cruce, mutación y selección (Mitchell, 1996/1998, apartado 5.5).
Para ver cómo se pierde la diversidad, SelectionMechanisms simula muchas veces una población que solo se somete a la selección, sin cruce ni mutación. Cada individuo tiene un identificador (ID) y sus copias lo heredan. El número de IDs distintos que quedan en la población mide la diversidad: empieza en N, y llega a 1 cuando todos son copias del mismo individuo.
Datos. En SelectionMechanisms, escribe Population size (N) 100, Generations (G) 10, Simulations 30, Fitness distribution per ID «Permutation 1..N (no repetition)», Seed (optional) 1 y Elitism (n elites) 1. Pulsa Run con tres valores de Method: Tournament (con Tournament size (k) 2), Roulette wheel y SUS. Mira la pestaña Summary.
Predice. ¿Qué mecanismo conserva más IDs distintos después de 10 generaciones? ¿Y cuál tiene la aptitud media más alta?
Abrir y configurar: SelectionMechanisms
Ver el resultado
La tabla da, en la última generación y como promedio de las 30 simulaciones:
| Método | IDs distintos | Aptitud media |
|---|---|---|
| Torneo, k = 2 | 1,07 | 99,99 |
| Ruleta | 10,8 | 93,7 |
| SUS | 25,7 | 93,4 |
La diversidad se pierde por dos caminos: porque los mejores se multiplican y porque el azar del sorteo elimina individuos, sean buenos o malos (deriva genética, sección 5.6). Sin cruce ni mutación no entra nada nuevo. En un algoritmo genético completo, la mutación repone la diversidad que quita la selección. En el algoritmo de las figuras 9.1 a 9.4, con pm = 0,05, la población de 30 rutas se reduce en promedio a 4,5 rutas distintas en la generación 20 y a 2,8 al final. Con pm = 0,5 conserva unas 26 en la generación 20 y 21 al final, y termina con rutas más cortas (51,6 frente a 62,6). Cuando la población son copias de unas pocas rutas, el cruce de dos copias da otra copia y solo avanza lo que aporta la mutación. Volveremos a esta relación en la sección 9.9. Para frenar la pérdida, además de mutar más, se puede bajar la presión selectiva: un torneo menor, un mecanismo como el ranking (capítulo 5), o un elitismo pequeño (capítulo 8).
En SelectionMechanisms, con Method igual a Tournament, Population size (N) 100, Generations (G) 60, Simulations 30, Seed (optional) 1 y Elitism (n elites) 1, mira la gráfica de IDs distintos de la pestaña Diversity con Tournament size (k) 2 y con 5. ¿En qué generación baja de 10 el promedio de IDs distintos con cada valor? ¿Qué relación tiene con la presión selectiva?
Ver la solución
El promedio de IDs distintos en las generaciones 0 a 6 es:
| Generación | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| k = 2 | 100 | 56,6 | 34,9 | 22,1 | 13,3 | 7,9 | 4,5 |
| k = 5 | 100 | 39,3 | 13,8 | 4,2 | 1,3 | 1 | 1 |
9.8 ¿Cuántas réplicas? AvanzadoA
¿Cuánto nos podemos fiar de una media de 30 réplicas? ¿Y de una de 10?
La media de las réplicas también depende del azar: con otras 30 réplicas saldría un valor algo distinto. Esa variación se mide con el error típico de la media, que es la desviación típica de las réplicas dividida entre la raíz del número de réplicas:
\mathrm{EE} = \frac{s}{\sqrt{n}}
Cuando n es grande, la media de los resultados se parece a una distribución normal de media la del algoritmo y desviación típica EE, y se puede dar un intervalo de confianza del 95 % para la media (Talbi, 2009, p. 64):
\bar{x} \pm 1{,}96 \, \frac{s}{\sqrt{n}}
En la figura 9.1, con pm = 0,05, \bar{x} = 62{,}6, s = 5{,}2 y n = 30. El error típico es 5{,}2/\sqrt{30} \approx 0{,}95, y el intervalo, de 60,7 a 64,4. Si repitiéramos el experimento muchas veces, el 95 % de los intervalos calculados así contendría la media del algoritmo en este mapa, la que saldría con infinitas réplicas. Con menos réplicas, el intervalo es más ancho.
Para comparar dos configuraciones se hace lo mismo con su diferencia, y cómo se calcula depende del diseño del experimento. En la sección 9.4, pm = 0,05 y pm = 0,2 usan las mismas 30 semillas, así que el diseño es emparejado: en cada semilla se calcula la diferencia d_i entre la longitud final con 0,05 y con 0,2, y se aplican las fórmulas anteriores a esas 30 diferencias. Su media es 7,2, la diferencia de las medias (62,6 − 55,4); su desviación típica, 7,6, y el error típico, 7{,}6/\sqrt{30} \approx 1{,}39. El intervalo del 95 % va de 4,5 a 9,9. No incluye el 0, así que es difícil explicar la diferencia solo por el azar de las 30 réplicas: pm = 0,2 es mejor en este mapa.
Si cada configuración se hubiera ejecutado con sus propias semillas, no habría parejas: las dos muestras serían independientes, y el error típico de la diferencia se calcularía con los de las dos medias, \sqrt{0{,}95^2 + 1{,}03^2} \approx 1{,}40. Aquí los dos cálculos dan casi lo mismo, porque compartir la población inicial apenas influye en el resultado final: lo que sale con una semilla y 0,05 casi no dice nada de lo que sale con esa semilla y 0,2. Cuando la semilla influye de la misma manera en las dos configuraciones, el diseño emparejado da un intervalo más estrecho, y tratar los datos como independientes desaprovecha esa ventaja.
Como n está dentro de una raíz, hace falta mucho más trabajo para mejorar poco la precisión: para dividir por dos el error hay que multiplicar por cuatro las réplicas. Talbi recomienda al menos 10 ejecuciones y, si se puede, más de 100 (Talbi, 2009, p. 64). Con SelectionMechanisms se puede ver este efecto: tanto el número de simulaciones como la semilla son parámetros.
Datos. En SelectionMechanisms, con Method igual a Roulette wheel, Population size (N) 100, Generations (G) 10, Fitness distribution per ID «Permutation 1..N (no repetition)» y Elitism (n elites) 1, pulsa Run con Seed (optional) 1000, 2000, 3000, 4000 y 5000, primero con Simulations 10 y después con 100. Mira en Summary el valor de unique_ids_mean.
Predice. ¿Con cuál de los dos números de simulaciones son más parecidos entre sí los cinco resultados?
Abrir y configurar: SelectionMechanisms
Ver el resultado
| Semilla | 10 simulaciones | 100 simulaciones |
|---|---|---|
| 1000 | 9,5 | 10,43 |
| 2000 | 10,4 | 10,50 |
| 3000 | 12,0 | 10,52 |
| 4000 | 11,1 | 10,89 |
| 5000 | 11,1 | 10,82 |
Con la desviación típica de 5,2 de la figura 9.1, ¿cuántas réplicas hacen falta para que el intervalo de confianza del 95 % de la media tenga una semianchura de 1 como máximo, es decir, \bar{x} \pm 1? ¿Y de 0,5?
Ver la solución
Hay que cumplir 1{,}96 \cdot 5{,}2/\sqrt{n} \leq 1, es decir, n \geq (1{,}96 \cdot 5{,}2)^2 \approx 104 réplicas. Para \pm 0{,}5, la semianchura es la mitad, así que hacen falta cuatro veces más: n \geq (1{,}96 \cdot 5{,}2/0{,}5)^2 \approx 416. Con 30 réplicas, la semianchura es 1{,}96 \cdot 0{,}95 \approx 1{,}9, en línea con el intervalo de 60,7 a 64,4. Es la razón de que Talbi hable de «más de 100 si es posible».Explorar en SelectionMechanisms
- Pon Simulations a 10 y mira las bandas de las gráficas de Diversity. Sube a 100 y fíjate en cómo cambian la media y la banda p05–p95. La banda no se estrecha: muestra la variación de una simulación suelta, no la incertidumbre de la media.
- Pulsa Run varias veces con Seed (optional) vacío: cada vez es una semilla distinta, y los resultados cambian.
- Si repites con semillas, sepáralas bastante (por ejemplo, de 1000 en 1000): con semillas consecutivas, las simulaciones se solapan y los resultados salen casi iguales sin serlo.
9.9 Parámetros que interactúan AvanzadoA
Si cada parámetro tiene su mejor valor, ¿basta con ajustarlos de uno en uno?
No, porque los parámetros no actúan por separado: interactúan de forma no lineal, y por eso no se pueden optimizar uno a uno (Mitchell, 1996/1998, apartado 5.6). Ajustar los parámetros de uno en uno, por separado y sin estudiar cómo se influyen, no garantiza encontrar la mejor combinación (Talbi, 2009, p. 54). Lo hemos visto: en la sección 9.7, la presión selectiva y la diversidad dependen de k, y la mutación repone diversidad.
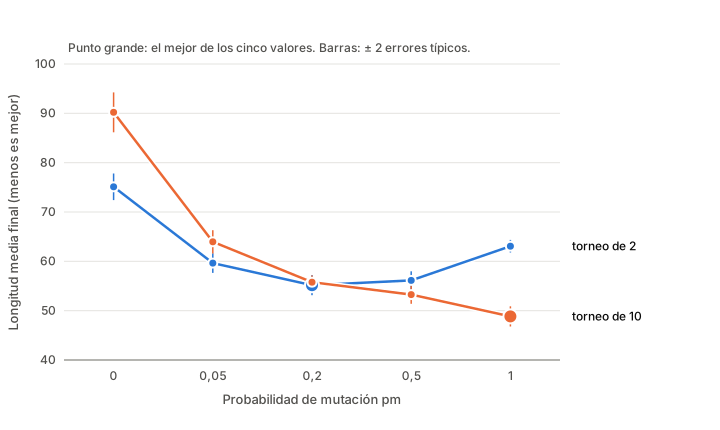
Con el mismo algoritmo, el mapa de 20 destinos y 30 réplicas hemos repetido el experimento de pm con un torneo de tamaño 2 y otro de 10.
figuras/09-experimentos.py, en el repositorio del libro.
Ver los datos de la figura
Longitud media final de 30 ejecuciones y, entre paréntesis, el error típico:
| pm | 0 | 0,05 | 0,2 | 0,5 | 1 |
|---|---|---|---|---|---|
| Torneo de 2 | 75,1 (1,3) | 59,6 (1,0) | 55,2 (1,0) | 56,1 (0,9) | 63,1 (0,6) |
| Torneo de 10 | 90,2 (2,0) | 64,0 (1,2) | 55,8 (0,7) | 53,3 (0,9) | 48,8 (1,0) |
Con un torneo de 2, el mejor valor de pm de los cinco es 0,2 y subirlo más empeora el resultado: con pm = 1 la media sube de 55,2 a 63,1. Con un torneo de 10, subir pm mejora el resultado hasta el último valor, pm = 1. No hay un valor de pm bueno por sí mismo: depende de k.
Con poca mutación, el torneo de 10 es el peor: con pm = 0 da 90,2, porque una selección tan fuerte llena enseguida la población de copias (sección 9.7). Con pm = 1, en cambio, los dos torneos mantienen la población llena de rutas distintas, unas 30 de 30 hasta el final. La diferencia está en qué rutas se mutan. Con un torneo de 10, los padres son casi siempre el mejor individuo o rutas muy buenas, y mutarlos a todos equivale a probar en cada generación unas 29 variaciones pequeñas de las mejores rutas: una búsqueda alrededor de lo mejor encontrado. Con un torneo de 2, muchos padres son rutas mediocres, y mutarlos a todos dispersa la búsqueda.
Hay una tercera pieza: el reemplazo. Mutar mucho estropea muchos hijos, pero con élite el mejor individuo pasa sin cambios y nunca se pierde (sección 8.3), así que equivocarse sale barato. Sin élite, el mejor valor de pm baja a 0,2 y mutar a todos los individuos es un desastre. Longitud media final de 30 ejecuciones en el mapa de 20 destinos, con torneo de 3:
| pm | 0,05 | 0,2 | 0,5 | 1 |
|---|---|---|---|---|
| Con un individuo de élite | 62,6 | 55,4 | 51,6 | 54,8 |
| Sin élite | 64,0 | 55,2 | 57,4 | 81,5 |
El mejor valor de pm depende, por tanto, de la selección y del reemplazo.
También hay interacción entre Pc y pm. Con pm = 0,05, subir Pc de 0 a 0,6 y 0,9 baja la media de 69,0 a 62,6 y a 59,9: cruzar ayuda. Con pm = 0,5, las medias son 51,2, 51,6 y 53,3, es decir, que el cruce apenas importa. Con mucha mutación y OX, este algoritmo casi no necesita el cruce: es, sobre todo, una búsqueda que muta y selecciona muchas rutas a la vez. En la sección 9.10 veremos que no ocurre lo mismo con un cruce que conserve lo que importa en el viajante.
Ver los datos del efecto de Pc
Longitud media final de 30 ejecuciones y, entre paréntesis, el error típico, en el mapa de 20 destinos con torneo de 3:
| Pc | 0 | 0,6 | 0,9 |
|---|---|---|---|
| pm = 0,05 | 69,0 (1,2) | 62,6 (0,9) | 59,9 (1,0) |
| pm = 0,5 | 51,2 (0,9) | 51,6 (1,0) | 53,3 (1,1) |
La consecuencia práctica es que hay que probar combinaciones. Un diseño factorial completo prueba todas las combinaciones de los valores («niveles») de cada parámetro («factor»). Con 4 parámetros y 5 niveles cada uno, son 5^4 = 625 combinaciones, y con 30 réplicas cada una, 18 750 ejecuciones. Es un coste alto, y se recortan combinaciones con diseños como el hipercubo latino, o se descartan pronto las configuraciones malas con algoritmos de carreras (racing) (Talbi, 2009, p. 55).
Empiezas con un torneo de 2 y ajustas pm con los datos de la figura 9.4. Después, con ese pm, pruebas un torneo de 10 por si mejora. ¿Con qué combinación te quedas? ¿Cuál es la mejor de las que hay en la figura? ¿Cuánto más larga sale la ruta media de la que eliges?
Ver la solución
Con torneo de 2, el mejor pm de los cinco es 0,2 (55,2). Con ese pm, el torneo de 10 da 55,8: no mejora, y nos quedamos con el torneo de 2. Pero la mejor combinación de la figura es un torneo de 10 con pm = 1, de 48,8. La ruta de nuestra elección es un 13 % más larga (55,2/48,8 ≈ 1,13). Ajustar de uno en uno nos ha dejado en un óptimo local del propio ajuste. Para encontrar el mejor hay que probar combinaciones.9.10 Operadores, representación y localidad AvanzadoA
Esta sección requiere las secciones 6.10 y 7.9.
Hemos ajustado Pc, pm y k con los operadores de EvoTraveller, cruce OX e intercambio. ¿Importa tanto el valor de los parámetros como la elección de los operadores?
En el viajante, la longitud de una ruta depende solo de qué ciudades son vecinas: de sus aristas (Talbi, 2009, p. 92). Un buen operador para este problema debe conservar la mayoría de las aristas de los padres. Es la localidad de la sección 7.10: un cambio pequeño en el cromosoma debe producir un cambio pequeño en la solución (Talbi, 2009, p. 209). En el cruce es la heredabilidad de la sección 6.1: los hijos deben parecerse a sus padres en lo que los hacía buenos. Lo que conserva cada operador depende de cómo se lee el cromosoma. OX conserva sobre todo el orden relativo y ERX, las adyacencias, que son las aristas (sección 6.10). El intercambio rompe hasta cuatro aristas y la inversión de un tramo, solo dos (sección 7.9).
Lo hemos medido en el mapa de 20 destinos, sobre 60 rutas buenas y distintas, de longitud media 46,8. Son óptimos locales de una búsqueda local con inversiones, desde rutas al azar. Cada ruta, con la salida y la vuelta al origen, tiene 21 aristas. Cada mutación se aplicó 50 veces a cada ruta, y cada cruce, 20 veces a cada una de 30 parejas:
| Operador | Aristas que conserva (de 21) | Cambio medio de longitud |
|---|---|---|
| Mutación por intercambio | 17,4 | 32,7 % |
| Mutación por inversión | 19,0 | 18,3 % |
| Cruce | Aristas del hijo que vienen de un padre | Longitud del hijo sobre el mejor padre |
|---|---|---|
| OX | 86 % | +24 % |
| PMX | 88 % | +24 % |
| CX | 81 % | +42 % |
| ERX | 96 % | +11 % |
La inversión y ERX son los operadores más locales para el viajante: rompen menos aristas y sus resultados se parecen más, en longitud, a las rutas de partida. ¿Se nota en el algoritmo genético? Lo repetimos con cada combinación de cruce y mutación, con el resto de los parámetros como en la figura 9.1 (Pc = 0,6 salvo en la fila sin cruce):
| Cruce | Intercambio, pm = 0,05 | Intercambio, pm = 0,5 | Inversión, pm = 0,05 | Inversión, pm = 0,5 |
|---|---|---|---|---|
| Sin cruce | 69,0 | 51,2 | 60,0 | 43,0 |
| OX | 62,6 | 51,6 | 53,9 | 42,5 |
| PMX | 65,1 | 48,9 | 55,2 | 43,0 |
| CX | 66,7 | 52,6 | 57,9 | 43,9 |
| ERX | 53,9 | 43,3 | 53,1 | 42,4 |
Ver todos los datos
Longitud media final de 30 ejecuciones y, entre paréntesis, el error típico:
| Mutación y pm | Sin cruce | OX | PMX | CX | ERX |
|---|---|---|---|---|---|
| Intercambio, 0,05 | 69,0 (1,2) | 62,6 (0,9) | 65,1 (0,9) | 66,7 (1,0) | 53,9 (0,9) |
| Intercambio, 0,2 | 57,3 (0,9) | 55,4 (1,0) | 56,7 (0,7) | 55,5 (1,0) | 48,0 (0,7) |
| Intercambio, 0,5 | 51,2 (0,9) | 51,6 (1,0) | 48,9 (1,0) | 52,6 (0,8) | 43,3 (0,6) |
| Intercambio, 1 | 53,6 (0,9) | 54,8 (1,0) | 52,8 (0,8) | 52,5 (0,9) | 52,2 (0,7) |
| Inversión, 0,05 | 60,0 (0,9) | 53,9 (0,8) | 55,2 (1,0) | 57,9 (0,7) | 53,1 (0,9) |
| Inversión, 0,2 | 45,9 (0,6) | 44,7 (0,5) | 45,0 (0,6) | 46,3 (0,6) | 44,6 (0,5) |
| Inversión, 0,5 | 43,0 (0,4) | 42,5 (0,4) | 43,0 (0,4) | 43,9 (0,5) | 42,4 (0,4) |
| Inversión, 1 | 45,5 (0,5) | 48,8 (0,6) | 46,4 (0,4) | 49,5 (0,5) | 45,7 (0,5) |
Con el intercambio, ERX mejora la media con todos los valores de pm probados, y la mejor media baja de 51,6 con OX a 43,3 con ERX, un 16 % menos. Ningún valor de pm consigue eso con OX. La mejor ruta que hemos encontrado para este mapa, repitiendo la búsqueda local con inversiones desde 300 rutas al azar, mide 40,68. Con ERX, además, el cruce sí ayuda aunque haya mucha mutación: con pm = 0,5 la media baja de 51,2 sin cruce a 43,3. Lo que vimos en la sección 9.9, que con mucha mutación el cruce apenas importa, era cierto para OX, que no conserva bien las aristas, no para cualquier cruce.
Con la inversión, en cambio, la mutación ya conserva las aristas y los cruces se parecen: con pm = 0,5, todos quedan entre 42,4 y 43,9, y sin cruce, en 43,0. El cruce ayuda sobre todo cuando la mutación es escasa (con pm = 0,05, de 60,0 sin cruce a 53,1 con ERX). Con los dos tipos de mutación, el mejor de los valores de pm probados sigue siendo 0,5. Como referencia, un escalador (hill climbing) que parte de la mejor de 30 rutas al azar y en cada generación prueba 29 mutaciones de la mejor ruta, y se queda con la mejor si no empeora, hace las mismas evaluaciones y llega a 54,9 con intercambios y a 42,2 con inversiones.
La conclusión es que los parámetros se ajustan después de elegir una representación y unos operadores que conserven lo que importa del problema. Afinar pm no compensa unos operadores con poca localidad. En EvoTraveller los operadores son fijos (OX e intercambio); para ver qué conserva cada uno, están las pantallas «Comparar operadores» de crossover-ga y mutation-ga (secciones 6.10 y 7.9).
Con OX e intercambio, nuestro punto de partida, la media es 62,6 con pm = 0,05. Con los datos de esta sección, ¿qué mejora más la media: subir pm a 0,5, o cambiar OX por ERX sin tocar pm? ¿Y hacer las dos cosas? ¿Por qué con la inversión casi da igual qué cruce se use?
Ver la solución
Subir pm a 0,5 baja la media a 51,6, un 18 % menos. Cambiar OX por ERX con pm = 0,05 la baja a 53,9, un 14 % menos. Las dos cosas a la vez, a 43,3, un 31 % menos, a un 6 % de la mejor ruta conocida (40,68). Con la inversión, la propia mutación hace una búsqueda local que respeta las aristas: el algoritmo llega a unos 42–44 con cualquier cruce, y la elección del cruce deja de ser decisiva.9.11 Ampliaciones Para saber más+
Ajuste previo con otro algoritmo. Como el ajuste de parámetros es un problema de optimización, se puede resolver con un algoritmo genético. Grefenstette lo hizo con un algoritmo genético de «nivel superior» cuya población eran 50 conjuntos de parámetros, y cada individuo codificaba el tamaño de la población, Pc, pm, el salto generacional, una técnica de escalado y si había elitismo; su aptitud dependía del rendimiento de un algoritmo genético con esos parámetros (Mitchell, 1996/1998, apartado 5.6). Talbi lo presenta como un esquema de dos niveles: el nivel superior optimiza los parámetros, y para evaluar cada uno de ellos hace falta ejecutar la metaheurística del nivel inferior sobre el problema real, de manera que es muy caro (Talbi, 2009, pp. 55–56).
Controlar los parámetros durante la ejecución. El mejor valor de un parámetro puede cambiar durante la búsqueda: por ejemplo, puede convenir más mutación cuando la población ha perdido diversidad. Talbi distingue tres formas de modificar los parámetros durante la ejecución: la actualización dinámica, que no mira cómo va la búsqueda (por ejemplo, un valor que baja con las generaciones), la adaptativa, que lo cambia según el progreso, y la autoadaptativa, en la que los parámetros se codifican en el cromosoma y evolucionan con las soluciones (Talbi, 2009, p. 56). Mitchell señala que muchos investigadores consideran el ajuste en tiempo real el enfoque más prometedor, y que en las estrategias evolutivas el ritmo de mutación va codificado en el cromosoma (Mitchell, 1996/1998, apartado 5.6).
Robustez y sobreajuste. Si los parámetros se ajustan con unas instancias y se evalúa el algoritmo con las mismas, el resultado es demasiado favorable: los valores son excelentes para esas instancias y mucho peores para otras, y se pierde robustez ante instancias desconocidas (Talbi, 2009, p. 63). Por eso se separan las instancias de ajuste de las de evaluación. Pero si con las instancias de evaluación se comparan varias configuraciones para quedarse con la mejor, también ellas sirven para elegir, y la cifra de la ganadora vuelve a ser optimista. Para estimar sin trampa la calidad de la configuración elegida se usan tres grupos: unos casos para ajustar, otros de validación para elegir y otros de prueba, que se guardan hasta el final y se usan una sola vez, con la configuración ya elegida (Hastie et al., 2009, apartado 7.2). Lo haremos en la sección 10.6.
Contrastes estadísticos. El intervalo de confianza de la sección 9.8 es una forma sencilla de comparar. Talbi menciona otros contrastes: el de la t de Student para datos emparejados cuando son aproximadamente normales, y el de Wilcoxon, el de permutaciones y el de Mann–Whitney cuando no lo son (Talbi, 2009, pp. 63–64). También se usa el porcentaje de éxito: el cociente entre las ejecuciones que alcanzan una solución de referencia (el óptimo, la mejor conocida u otra fijada de antemano) y el total de ejecuciones (Talbi, 2009, p. 64). Es lo que hicimos en la sección 8.5: sin élite, 17 de 30 ejecuciones llegaron al óptimo, y con élite, las 30.
Resumen
- Un algoritmo genético usa números aleatorios, así que cada ejecución puede dar un resultado distinto. La semilla permite repetir una ejecución concreta, pero una sola ejecución no basta para saber cómo funciona el algoritmo.
- Se repite con varias semillas y se resumen los resultados con la media y la desviación típica. Una diferencia entre dos configuraciones solo es creíble si se mantiene al comparar las medias de muchas réplicas.
- No hay valores de Pc y pm buenos para todos los problemas: dependen de la representación, del tamaño del problema y del tiempo disponible. Hay que ajustarlos con casos parecidos al real.
- Una presión selectiva alta hace perder diversidad rápidamente, y la mutación la repone. Por eso los parámetros interactúan y se prueban en combinación, no de uno en uno.